Seedream - v4.5
Parole Chiave e Tag Correlati
Immagini in evidenza
Parametri Consigliati
resolution
Suggerimenti
Utilizza la Guida Ufficiale per il prompting di Seedream 4.5 disponibile da Bytedance per ottenere i migliori risultati.
Sfrutta le potenti capacità di rendering del testo del modello per piccoli font e tipografie complesse.
Approfitta dell'inferenza veloce per generare rapidamente immagini ad alta risoluzione.
Sponsor del Creatore
Seedream 4.5 - ora con risoluzione 4k senza costi aggiuntivi!
Consulta la Guida Ufficiale estremamente utile per il prompting di Seedream 4.5, di Bytedance!
Dettagli pubblicati originariamente su: https://seed.bytedance.com/en/tech/seedream3_0
Innovazione Tecnica
Rispetto al nostro modello precedente Seedream 2.0, adottiamo diverse strategie innovative per affrontare le sfide esistenti, tra cui risoluzioni limitate delle immagini, adesione a attributi complessi, generazione tipografica dettagliata e qualità estetica e fedeltà visiva subottimali.
Questo si riflette principalmente nei seguenti quattro aspetti:
• A livello di dati, la scala del dataset è stata ampliata di circa il 100% con un nuovo meccanismo di campionamento dinamico che opera su due assi ortogonali: distribuzione dei cluster di immagini e coerenza semantica testuale.
• Nella fase di pretraining, implementiamo diversi miglioramenti rispetto alla versione 2.0, ottenendo migliore scalabilità, generalizzabilità e allineamento visivo-linguistico: i) Addestramento a Risoluzione Mista; ii) RoPE Cross-modality; iii) Perdita di Allineamento della Rappresentazione; iv) Campionamento Timestep consapevole della Risoluzione.
• Durante l’ottimizzazione post-training, utilizziamo didascalie estetiche diversificate e un modello di ricompensa basato su VLM per migliorare ulteriormente le capacità complessive del modello.
• Nell’accelerazione del modello, promuoviamo un campionamento stabile tramite un'aspettativa di rumore coerente, riducendo efficacemente il numero di valutazioni di funzione (NFE) durante l’inferenza.
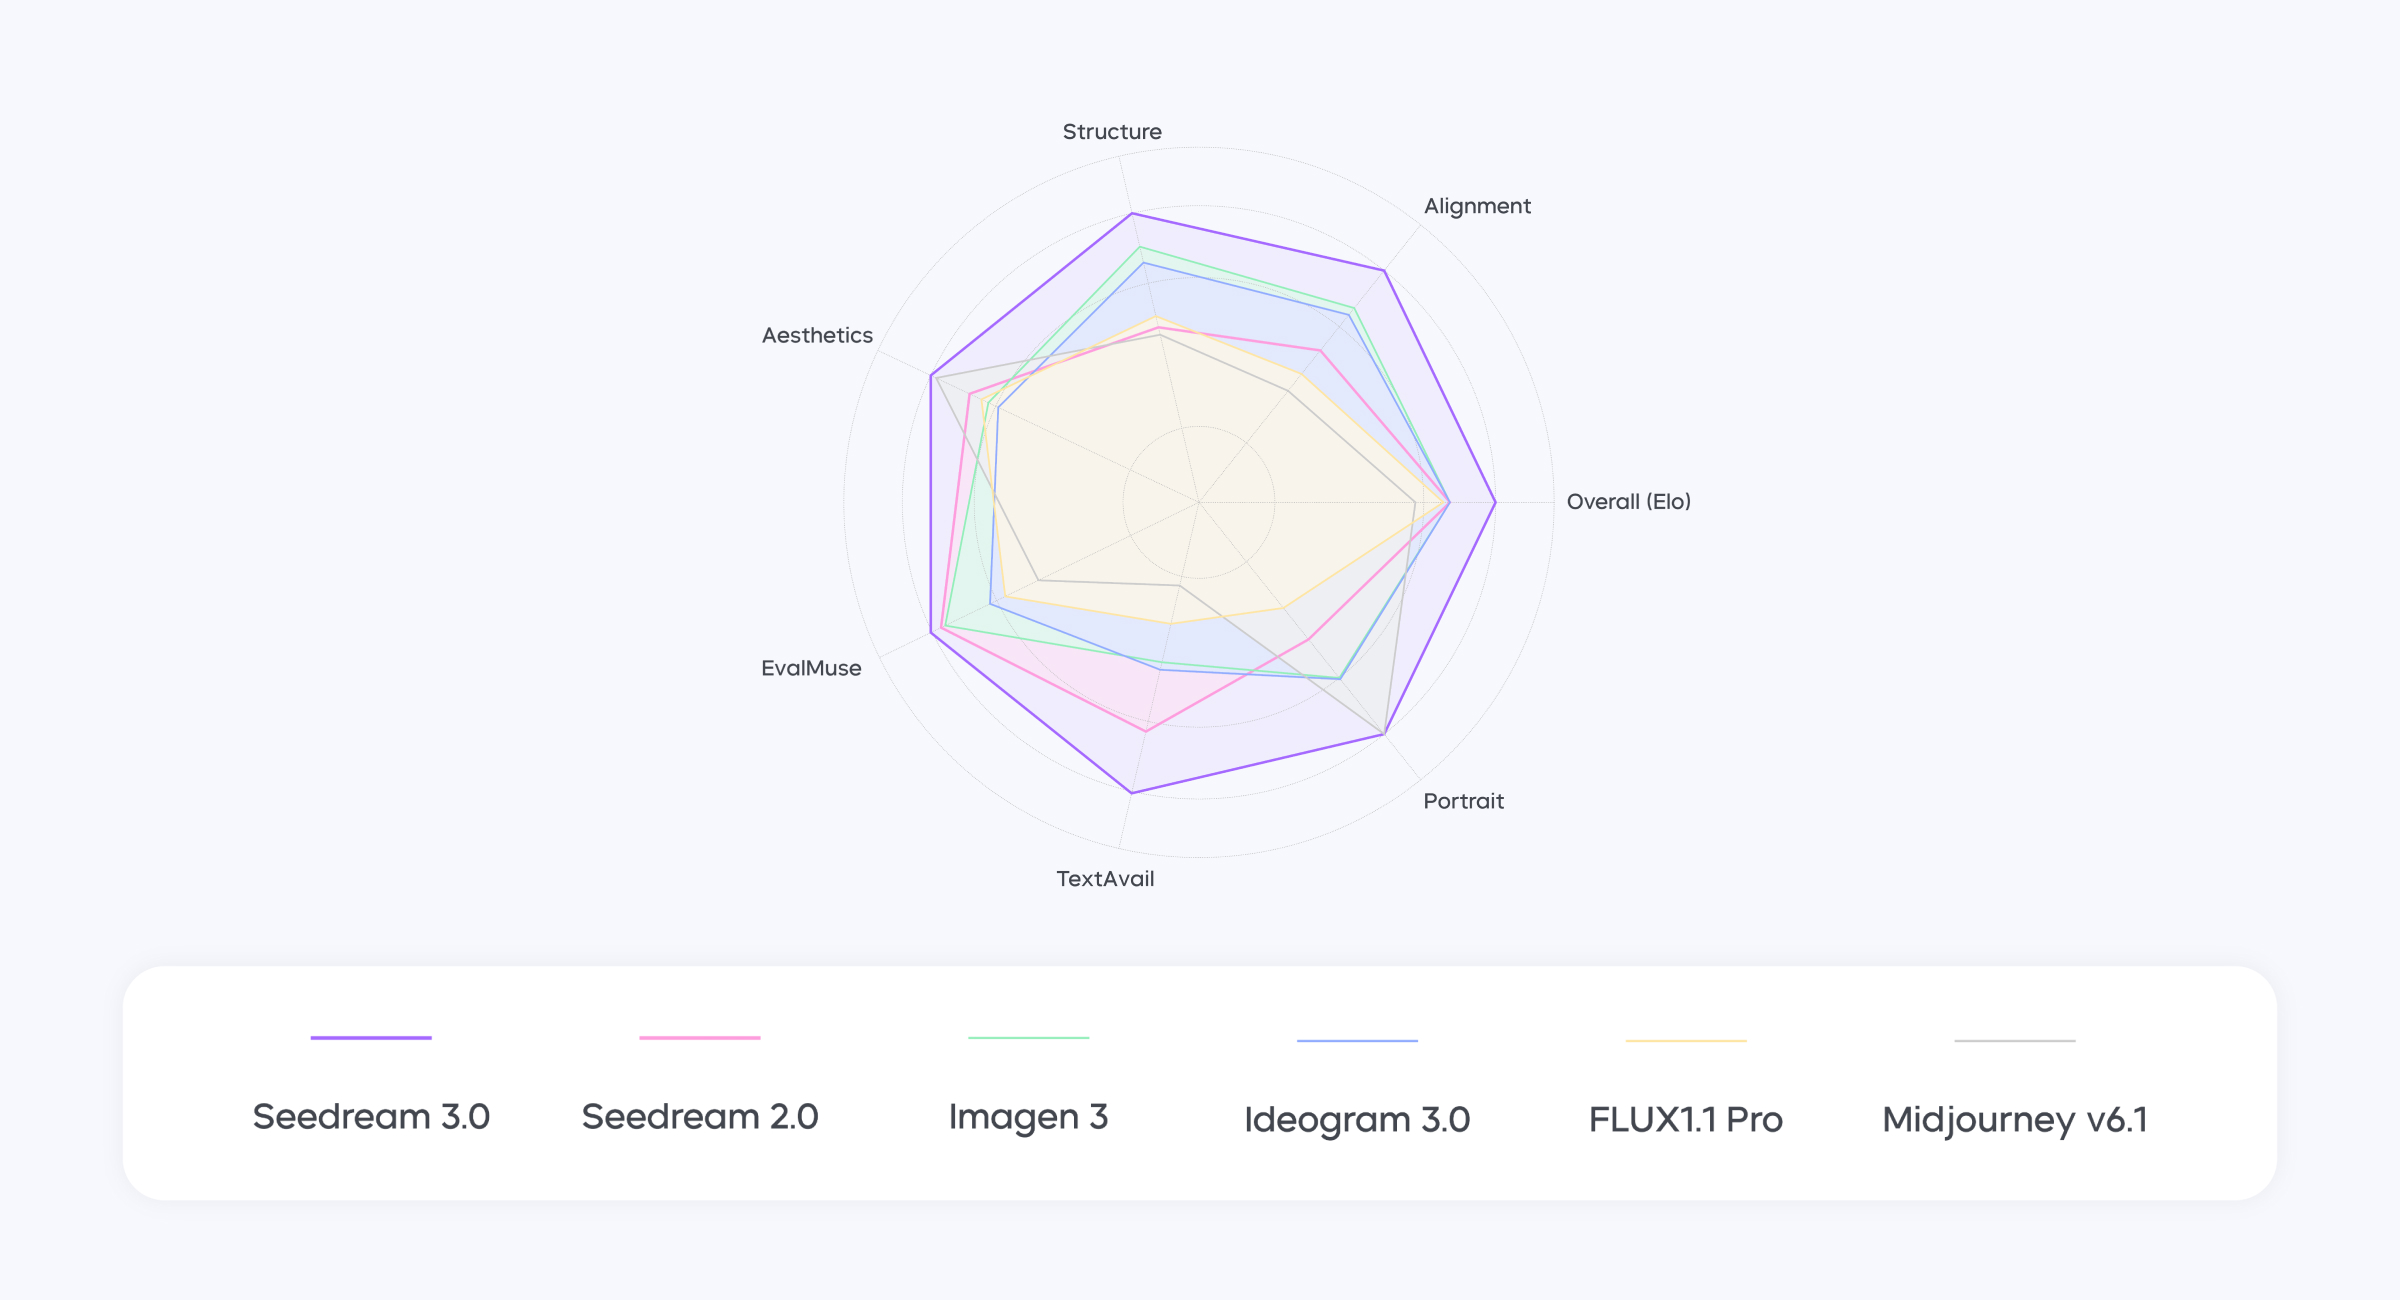
Figura 1 Seedream 3.0 si posiziona primo nella classifica Artificial Analysis Image Arena Leaderboard. A causa di dati mancanti, il risultato Portrait per Imagen 3 e il risultato Overall per Seedream 2.0 sono rappresentati dai valori medi degli altri modelli.
Prestazioni Iterative del Modello
Rispetto a Seedream 2.0, Seedream 3.0 raggiunge significativi progressi su più dimensioni:
• Risoluzione nativa elevata: Supporta nativamente output in risoluzione 2K senza post-processing, ed è compatibile con risoluzioni superiori e adattabile a vari rapporti d’aspetto.
• Miglioramenti delle capacità complessive: Dimostra miglioramenti significativi in allineamento testo-immagine, progettazione strutturale compositiva, qualità estetica e capacità di rendering del testo.
• Significativi miglioramenti nel rendering del testo: Eccelle nella generazione di piccoli font, accuratezza dei caratteri cinesi e layout di testi lunghi con elevata qualità estetica. Il modello affronta sfide industriali nella generazione di testo piccolo e nel layout di testi lunghi, con output di graphic design che superano template progettati manualmente da piattaforme come Canva. Grazie a capacità precise e raffinate di generazione testuale, permette la creazione senza sforzo di poster di livello designer, integrando perfettamente diversi font, stili e layout.
• Miglioramenti estetici: Ottiene miglioramenti significativi nella qualità estetica delle immagini, con elevate prestazioni nel rendering di scene cinematografiche e generazione di ritratti con texture più realistiche.
• Esperienza di generazione rapidissima: Grazie a molteplici tecnologie innovative di accelerazione, i costi di inferenza sono significativamente ridotti. La generazione end-to-end di immagini a risoluzione 1K ora richiede solo 3,0 secondi.
Figura 2 Risultati di valutazione umana.Seedream 3.0 supera altri modelli in termini di corrispondenza immagine-testo, struttura ed estetica.

Dettagli del Modello
Tipo di modello
Modello base
Versione del modello
Hash del modello
Creatore

Discussione
Per favore log in per lasciare un commento.
Collezione di Modelli - Seedream
Immagini di Seedream - v4.5
Immagini con modello base