Trzydzieści sekund, które Seedance 2.5 generuje w jednym ujęciu
Dwa razy więcej niż pułap serii 2.0, z maksymalnie 30 wejściami referencyjnymi i dźwiękiem powstającym razem z obrazem, a nie dodawanym potem.
Seedance 2.5 i pięć modeli, z którymi byś go porównał
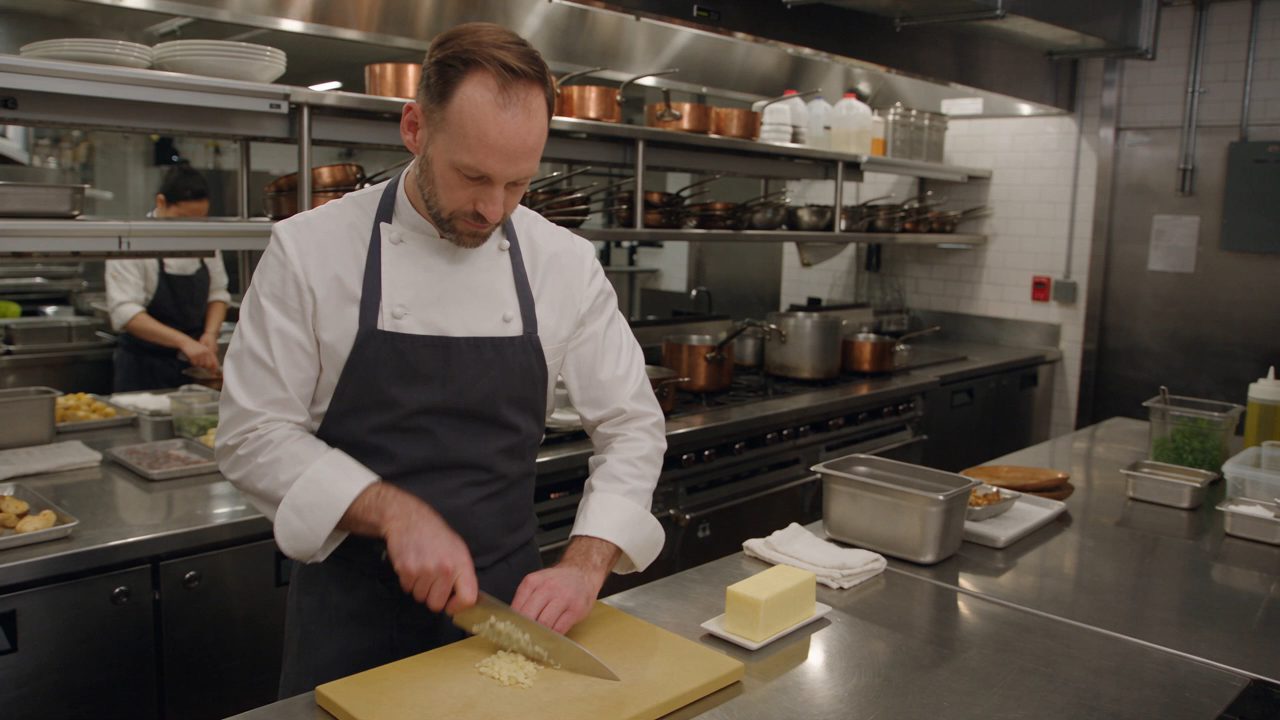
Przepuściliśmy ten sam prompt przez wszystkie sześć. Każdy z nich jest w polu powyżej.
“A chef in a busy kitchen looks straight at camera and says, "the secret is butter."”
 Na tej stronie
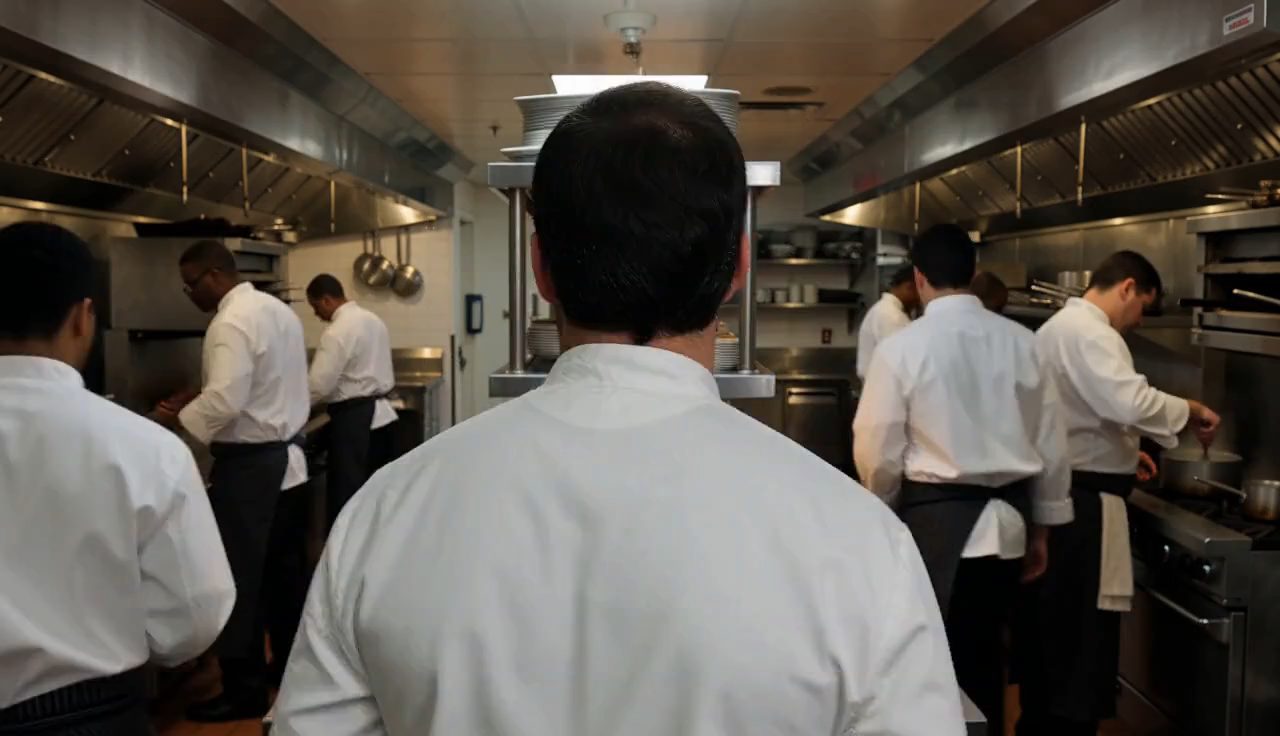
MiniMax H3
Układ ust względem ścieżki dźwiękowej.
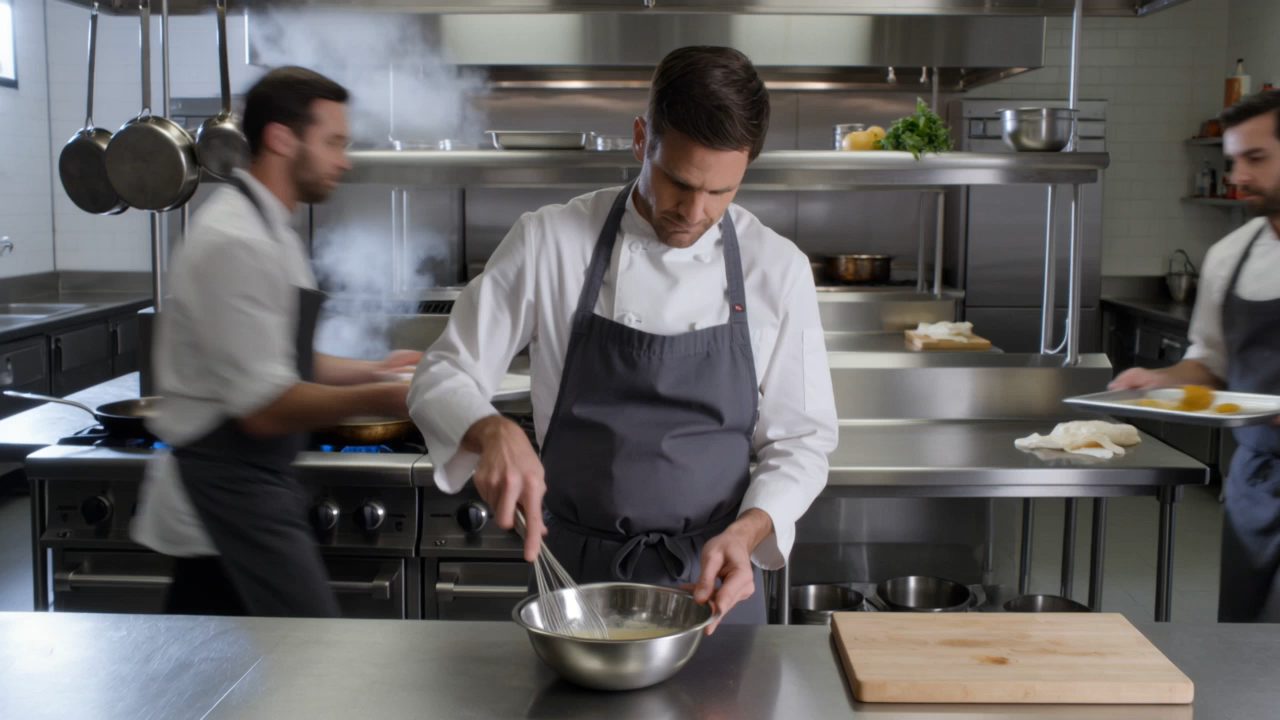
Kling 3 Omni
Detal skóry i włosów, gdy kamera się uspokaja.
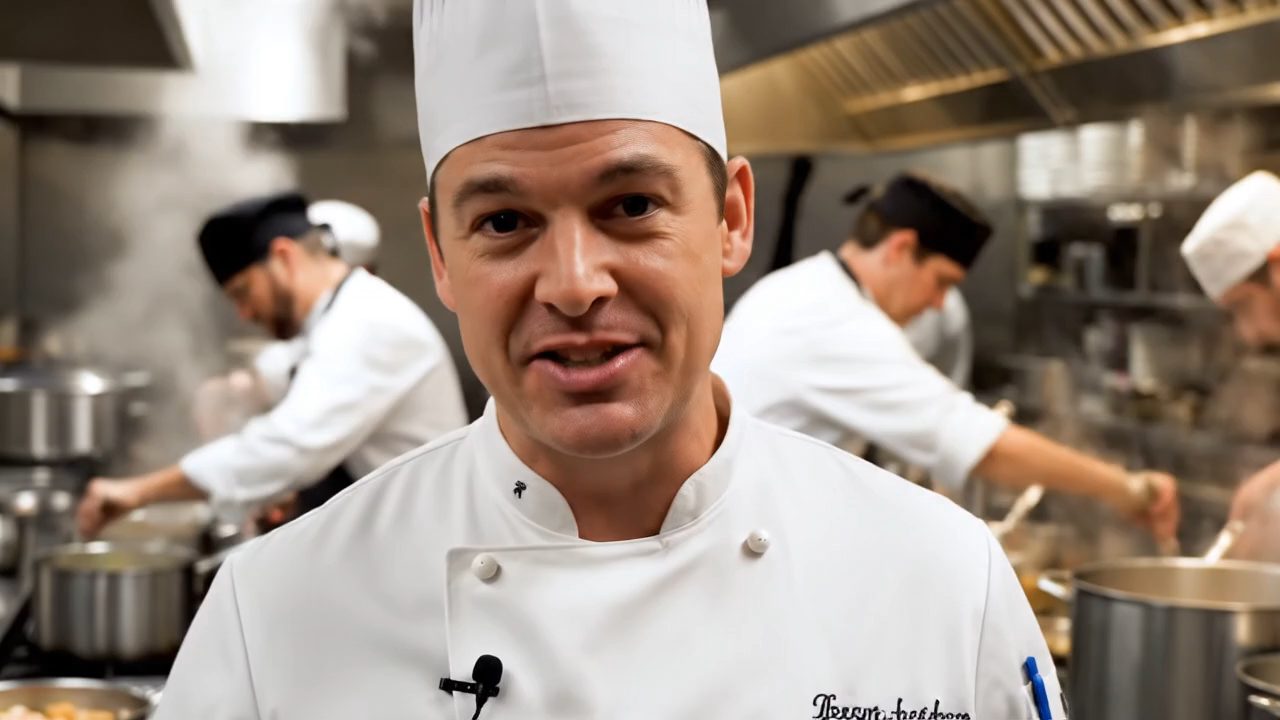
Veo 3.1
Czy spojrzenie trzyma obiektyw.
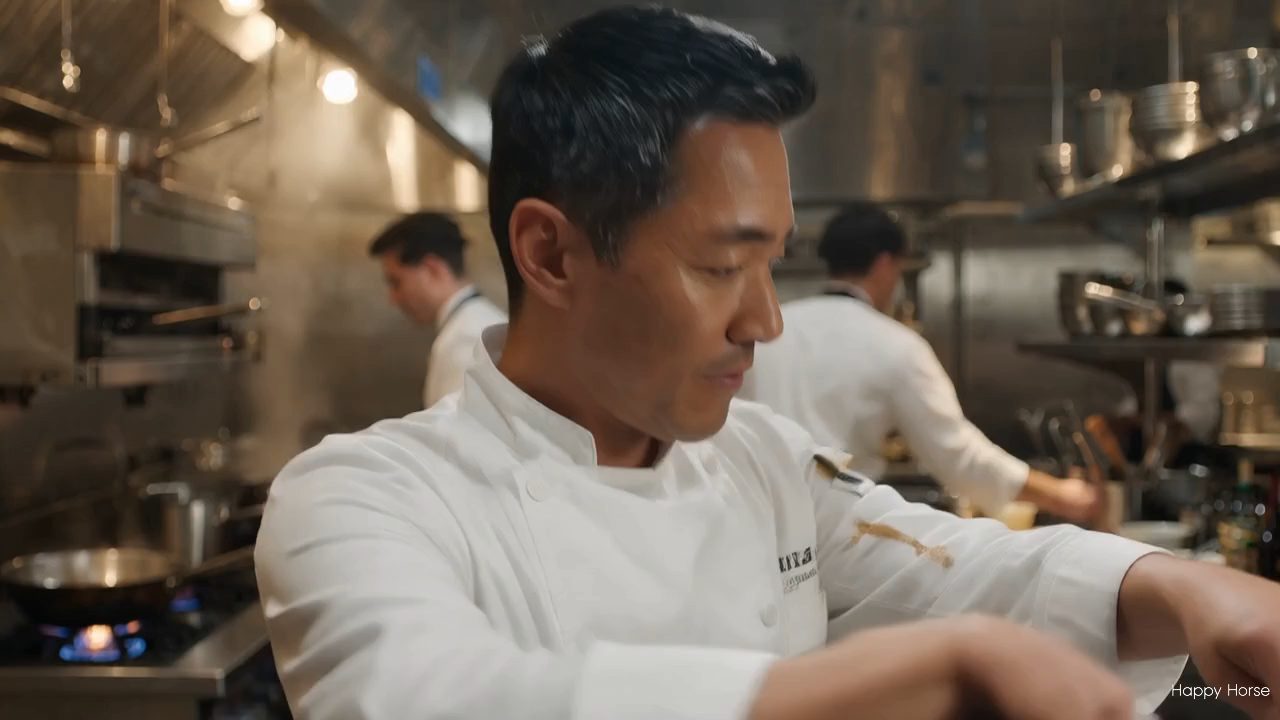
Happy Horse 1.0
Jak trzyma się twarz, gdy głowa się obraca.
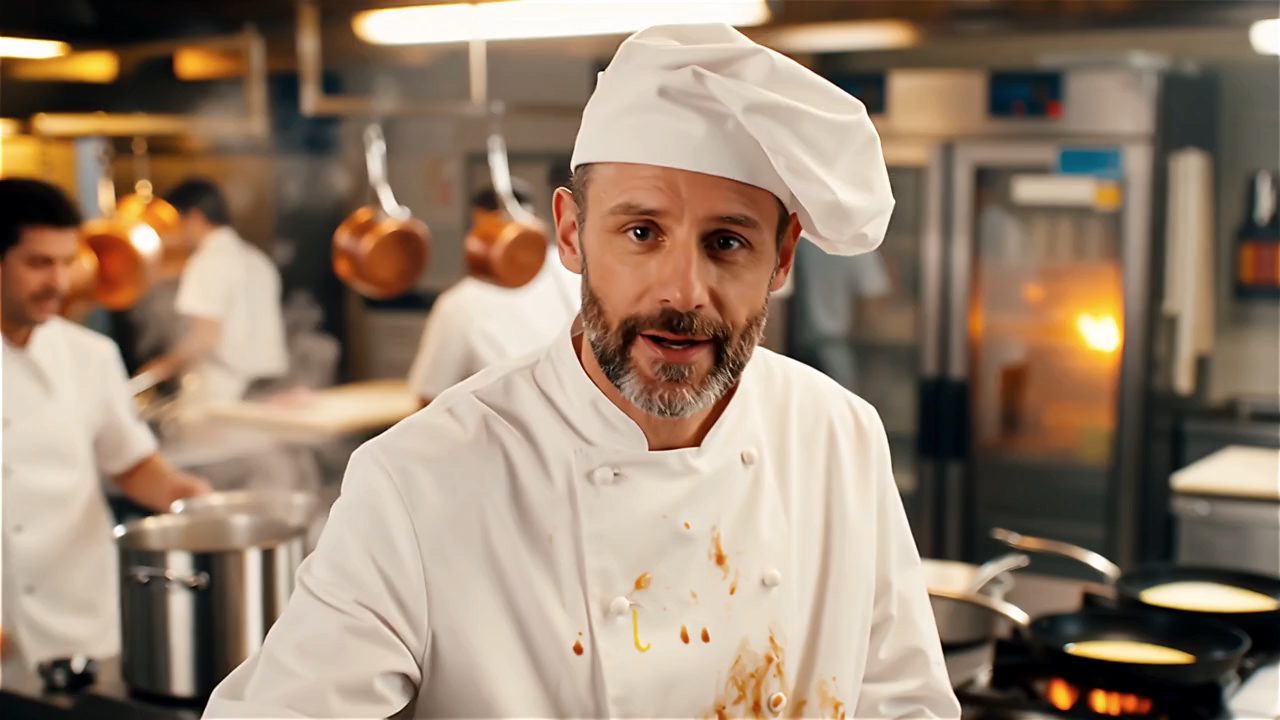
Wan 2.5
Jak z bliska wypadają skóra i tkanina.
“Handheld shot following a cyclist through a rainy neon alley, water spraying from the tyres.”
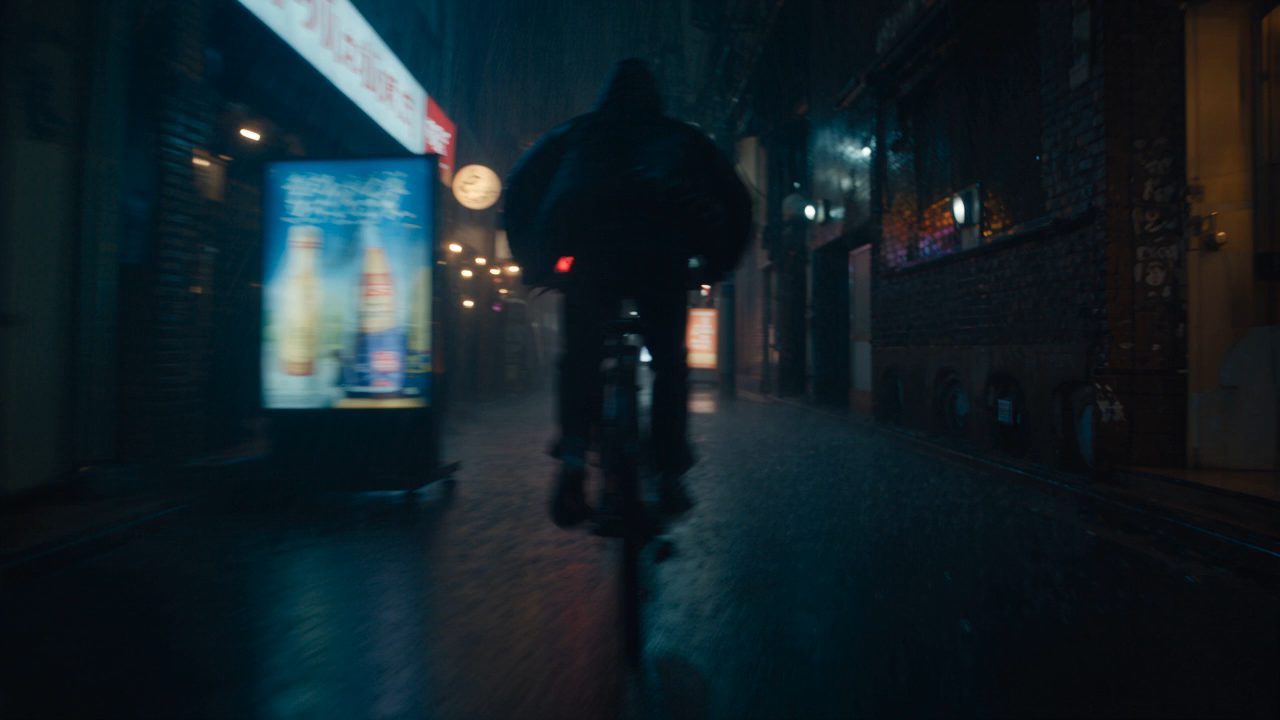 Na tej stronie
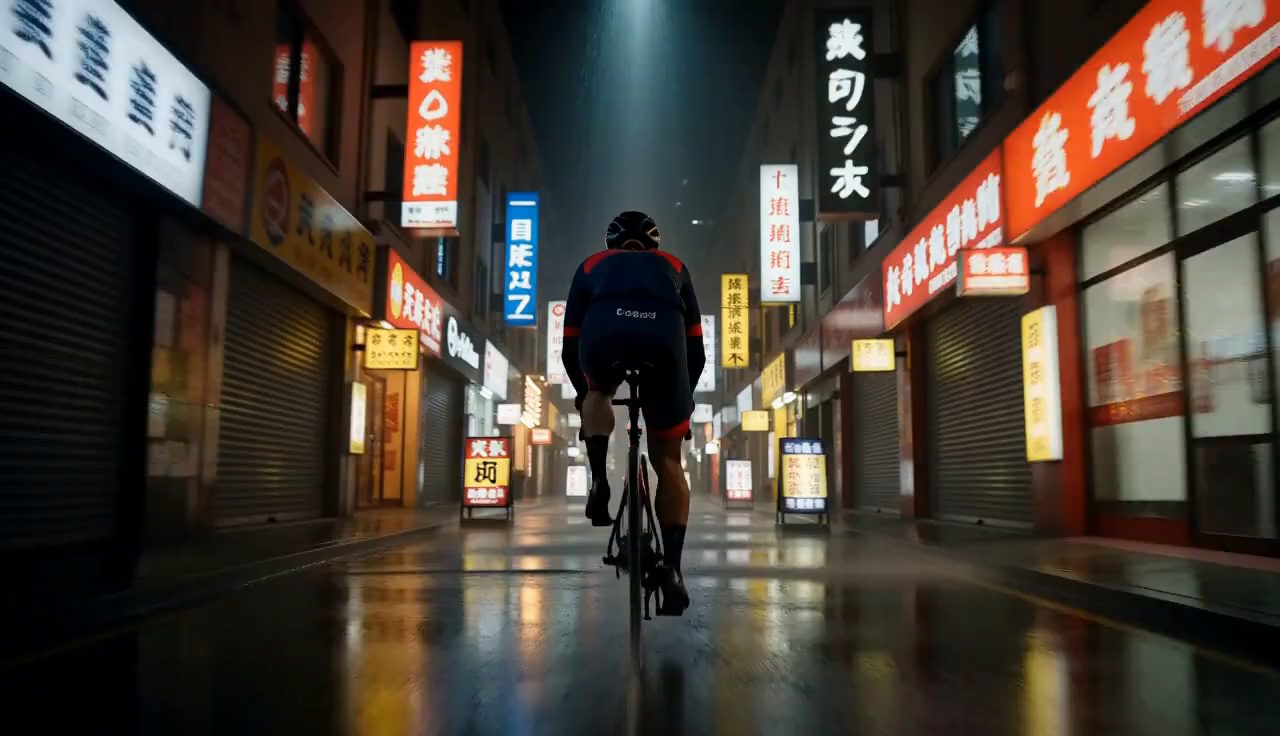
MiniMax H3
Rozmycie ruchu w najszybszej części panoramy.
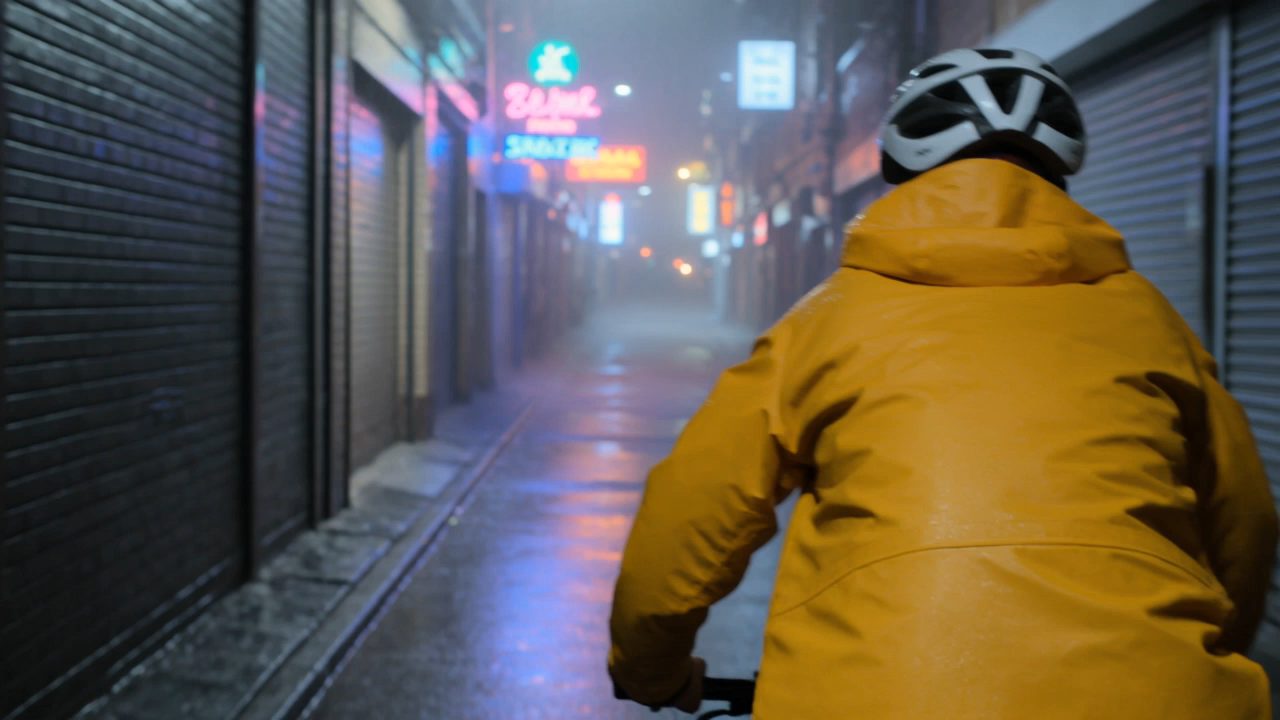
Kling 3 Omni
Kończyny w momencie skrętu.
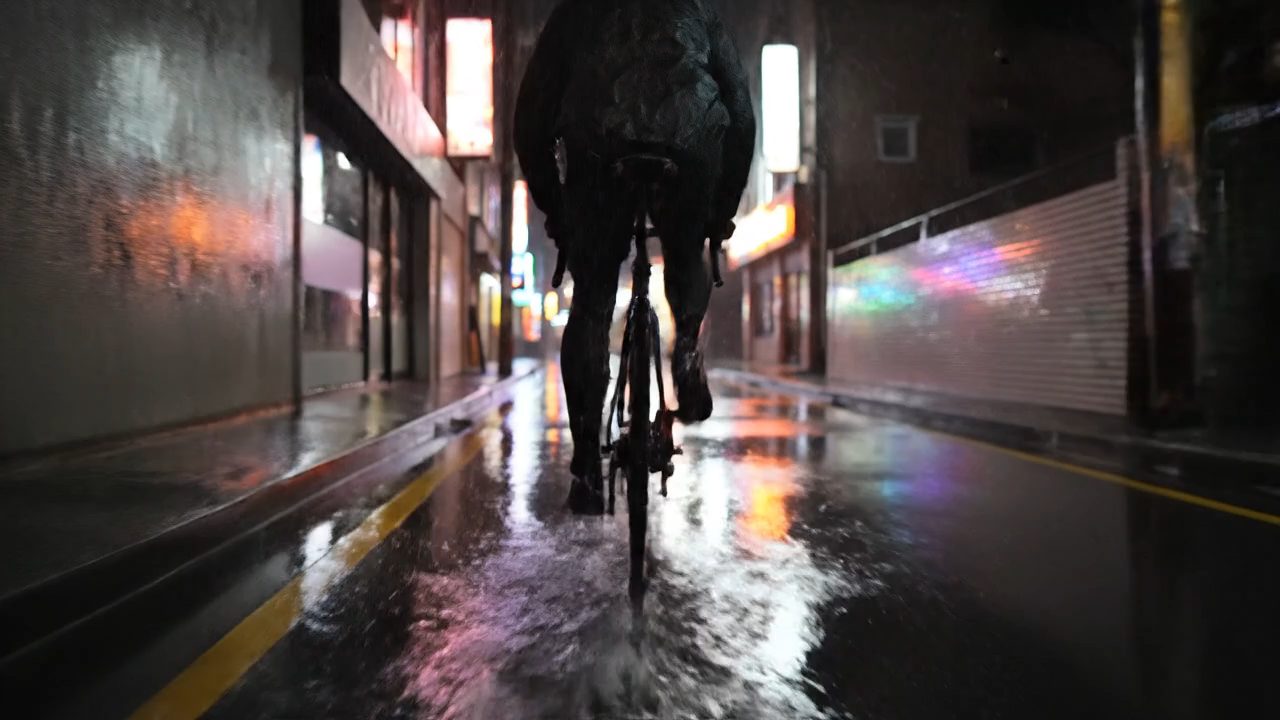
Veo 3.1
Odbicia podążające za źródłem światła.
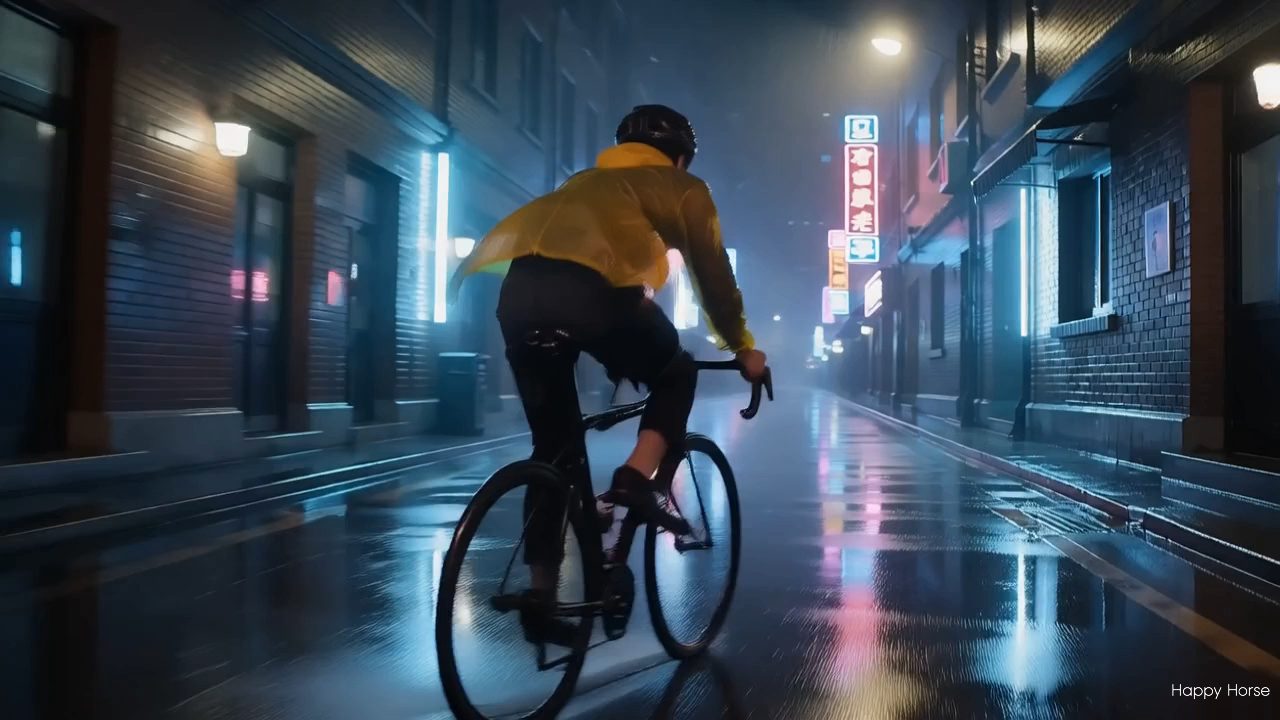
Happy Horse 1.0
Czy kadr pozostaje ostry, gdy kamera się porusza.
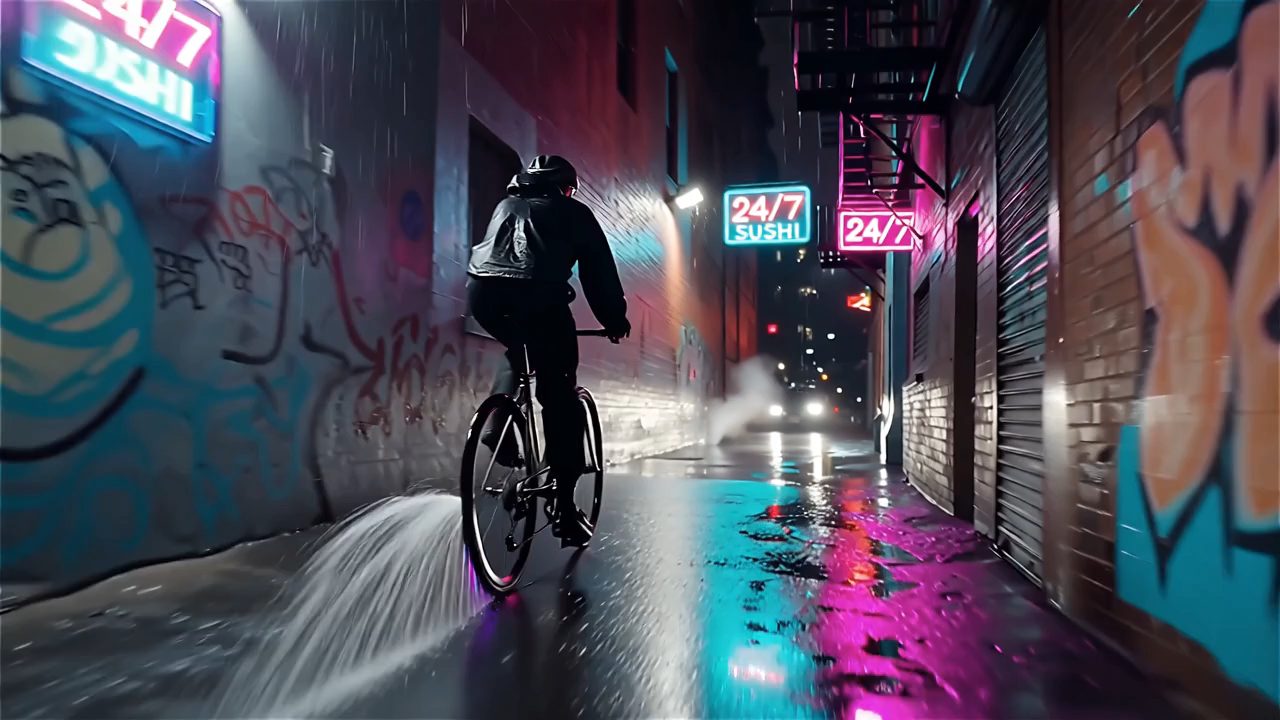
Wan 2.5
Jak trzyma się tło.
“A neon sign reading OPEN LATE flickers above a diner door at night.”
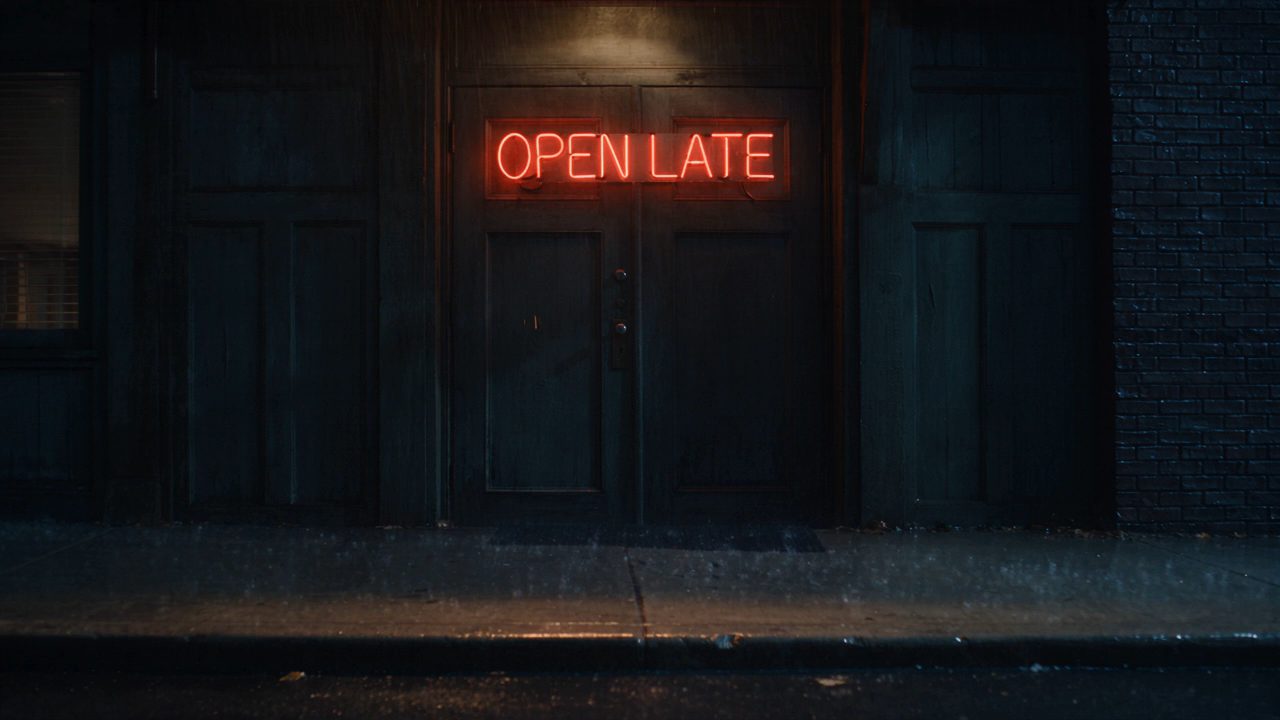 Na tej stronie
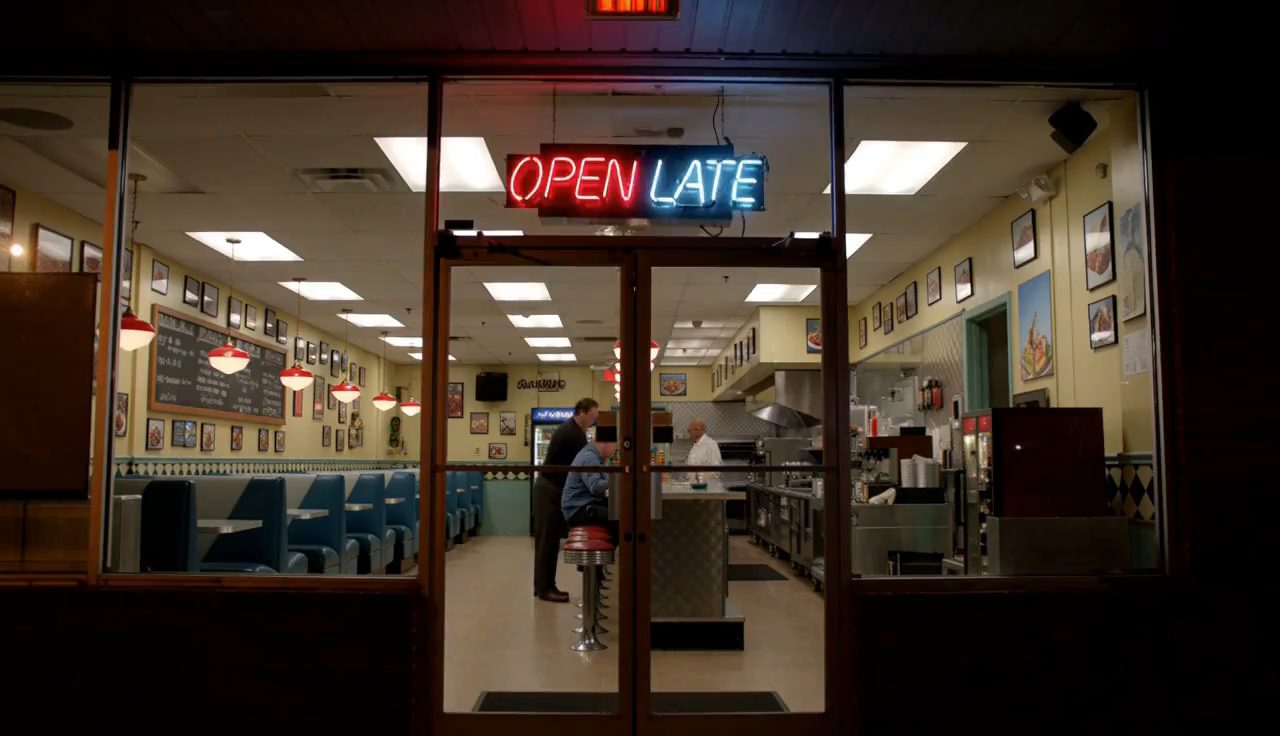
MiniMax H3
Kształty liter, gdy szyld wchodzi w ostrość.
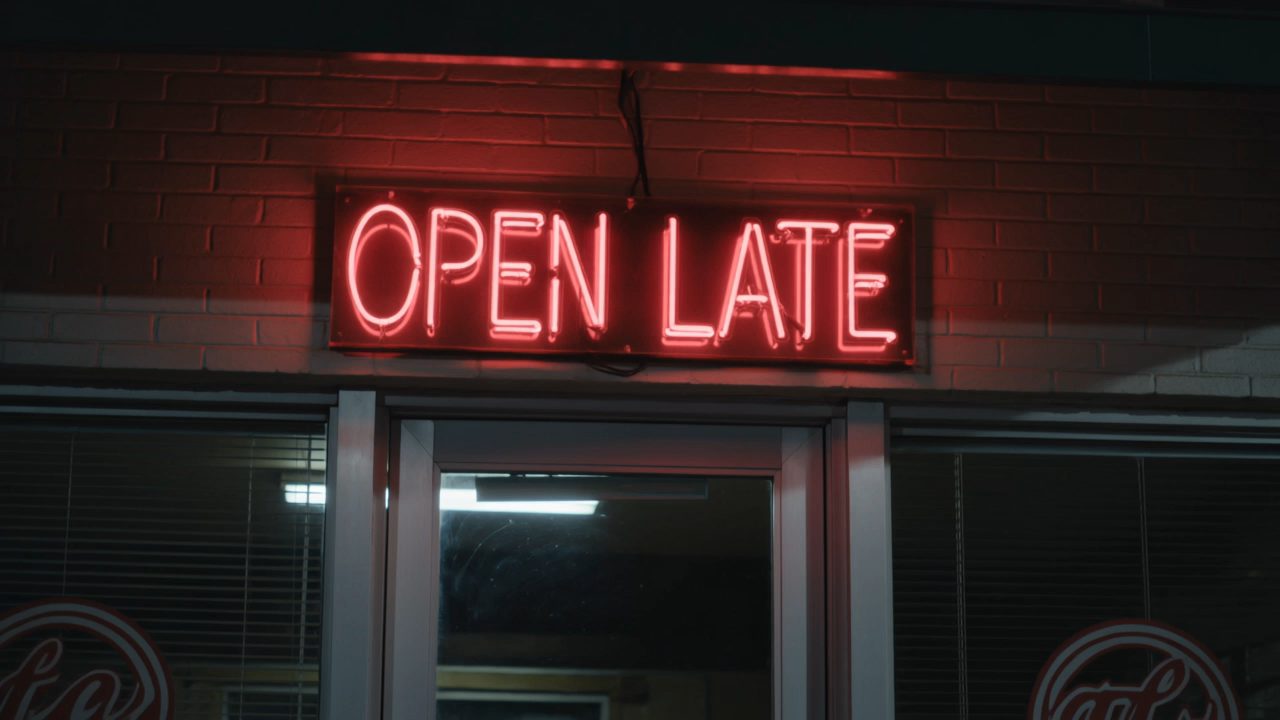
Kling 3 Omni
Pisownia, a nie tylko kształt liter.
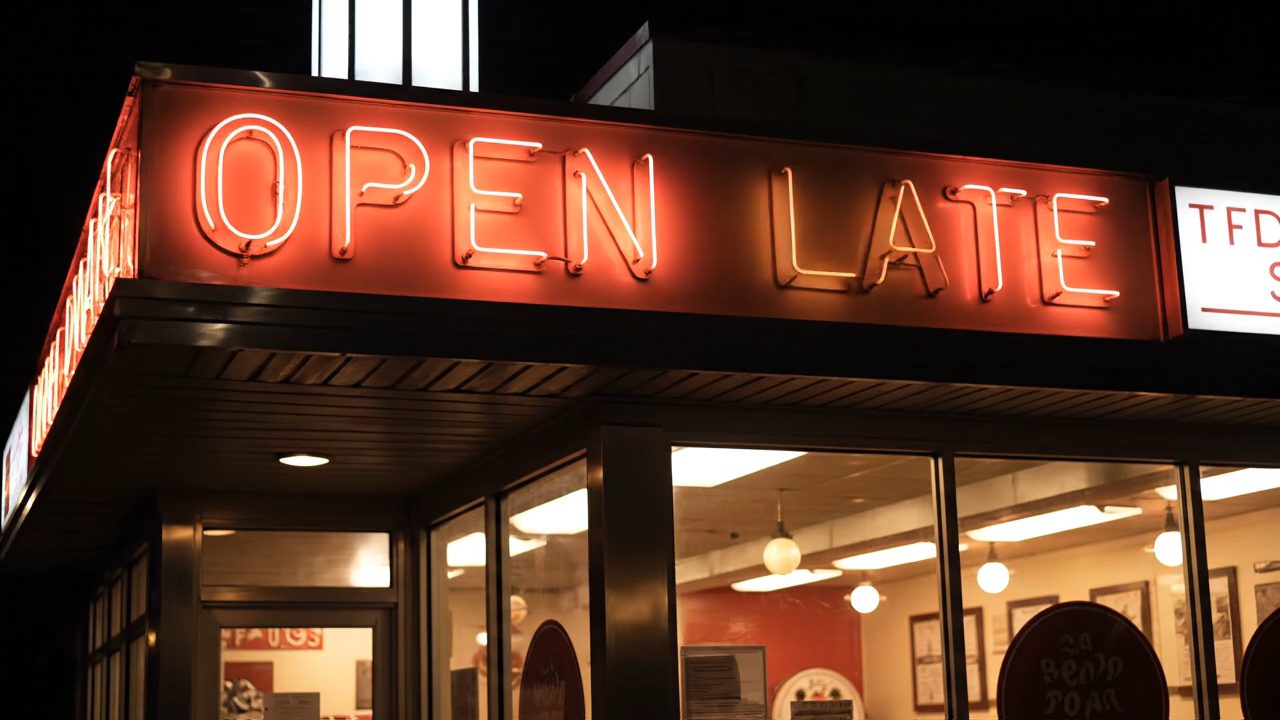
Veo 3.1
Światło międzyliterowe na tle neonu.
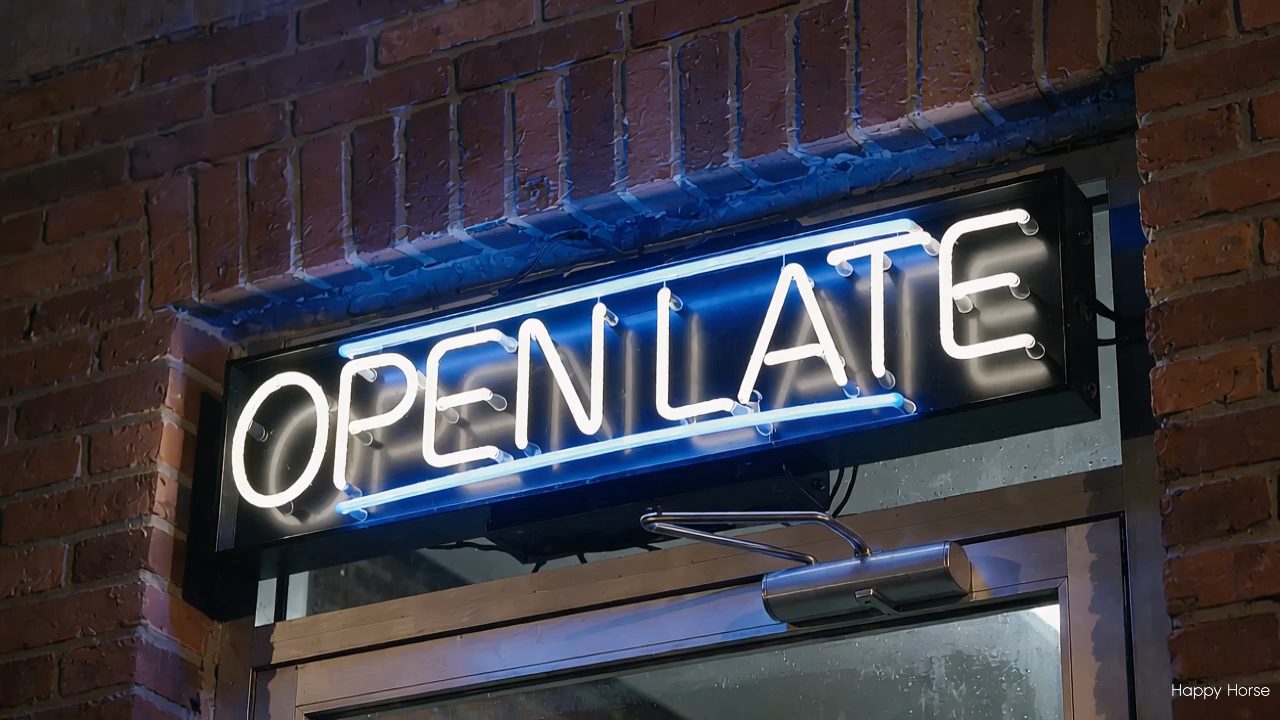
Happy Horse 1.0
Drobny tekst, gdy szyld wchodzi w ostrość.
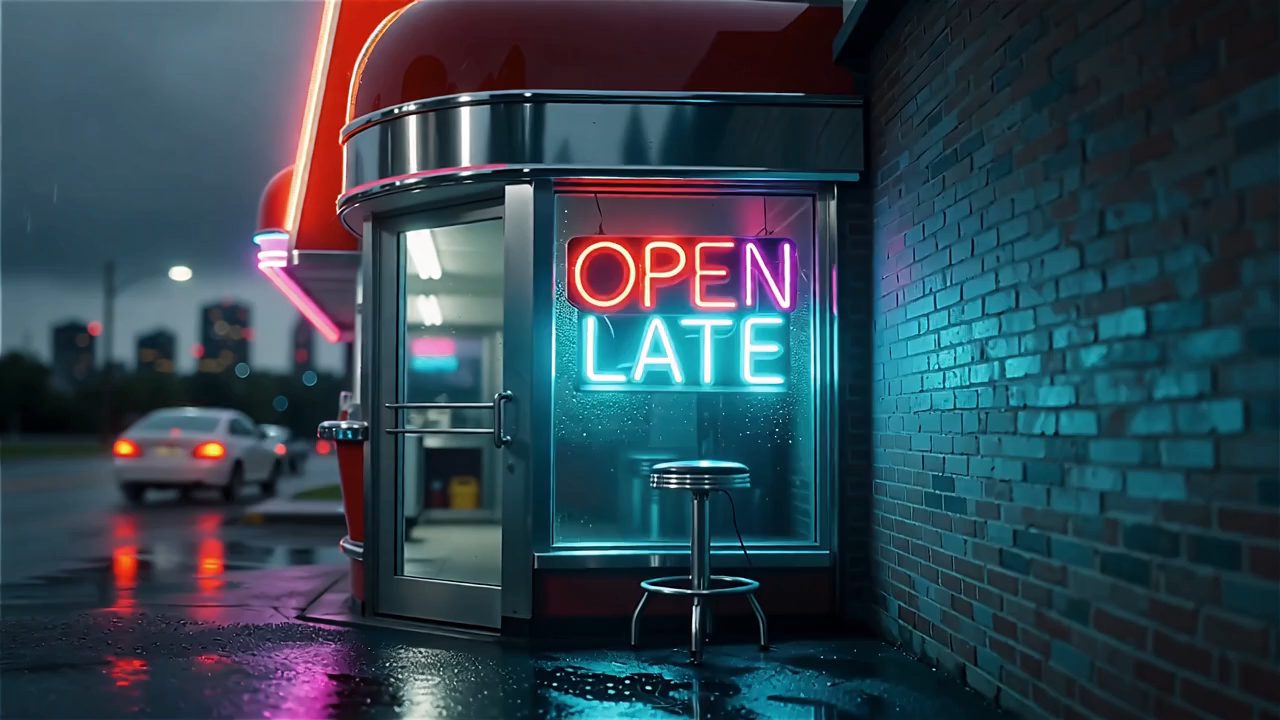
Wan 2.5
Jak trzymają się litery na krawędzi poświaty.


Dlaczego Seedance 2.5 się wyróżnia
Każda liczba poniżej to rzeczywisty zakres modelu w naszym generatorze, w porównaniu z siedemnastoma modelami obok.
Dwa razy więcej niż pułap serii 2.0 — od 4 do 30 sekund, co sekundę, zamiast sklejania krótkich klipów.
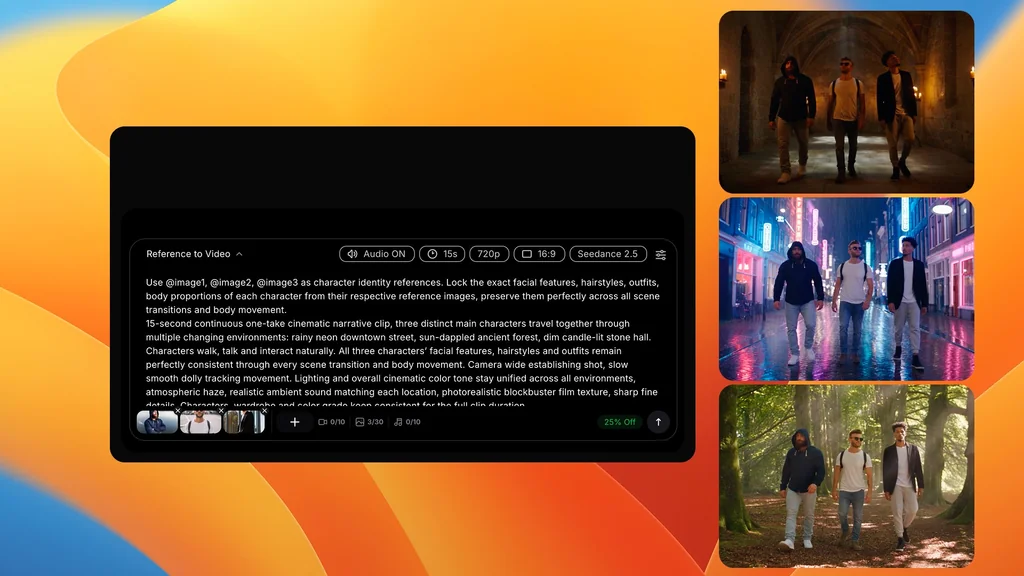
Tryb wielu referencji przyjmuje naraz do 30 obrazów, 10 ścieżek audio i 10 wideo — podczas gdy Seedance 2.0 zatrzymuje się na 9, 3 i 3. Wystarczy, by utrzymać obsadę i styl w całej scenie.
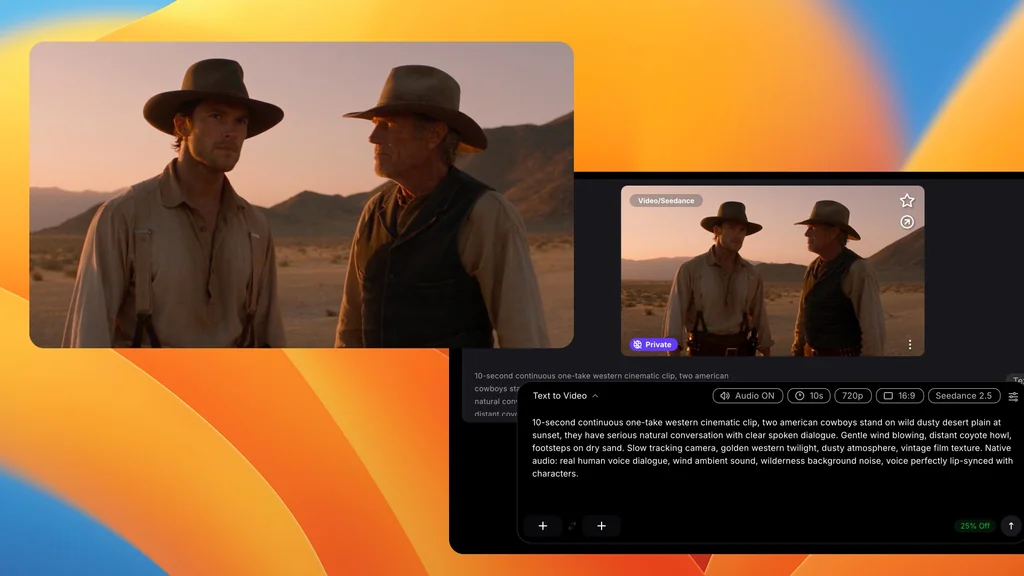
Sześć proporcji, od 21:9 po 9:16, ze ścieżką dźwiękową powstającą razem z obrazem, a nie dodawaną potem.
Trzydzieści sekund w jednym generowaniu
Trzydzieści referencji, dziesięć audio, dziesięć wideo
Filmowe 21:9 z dźwiękiem w komplecie
Co możesz z tym zbudować
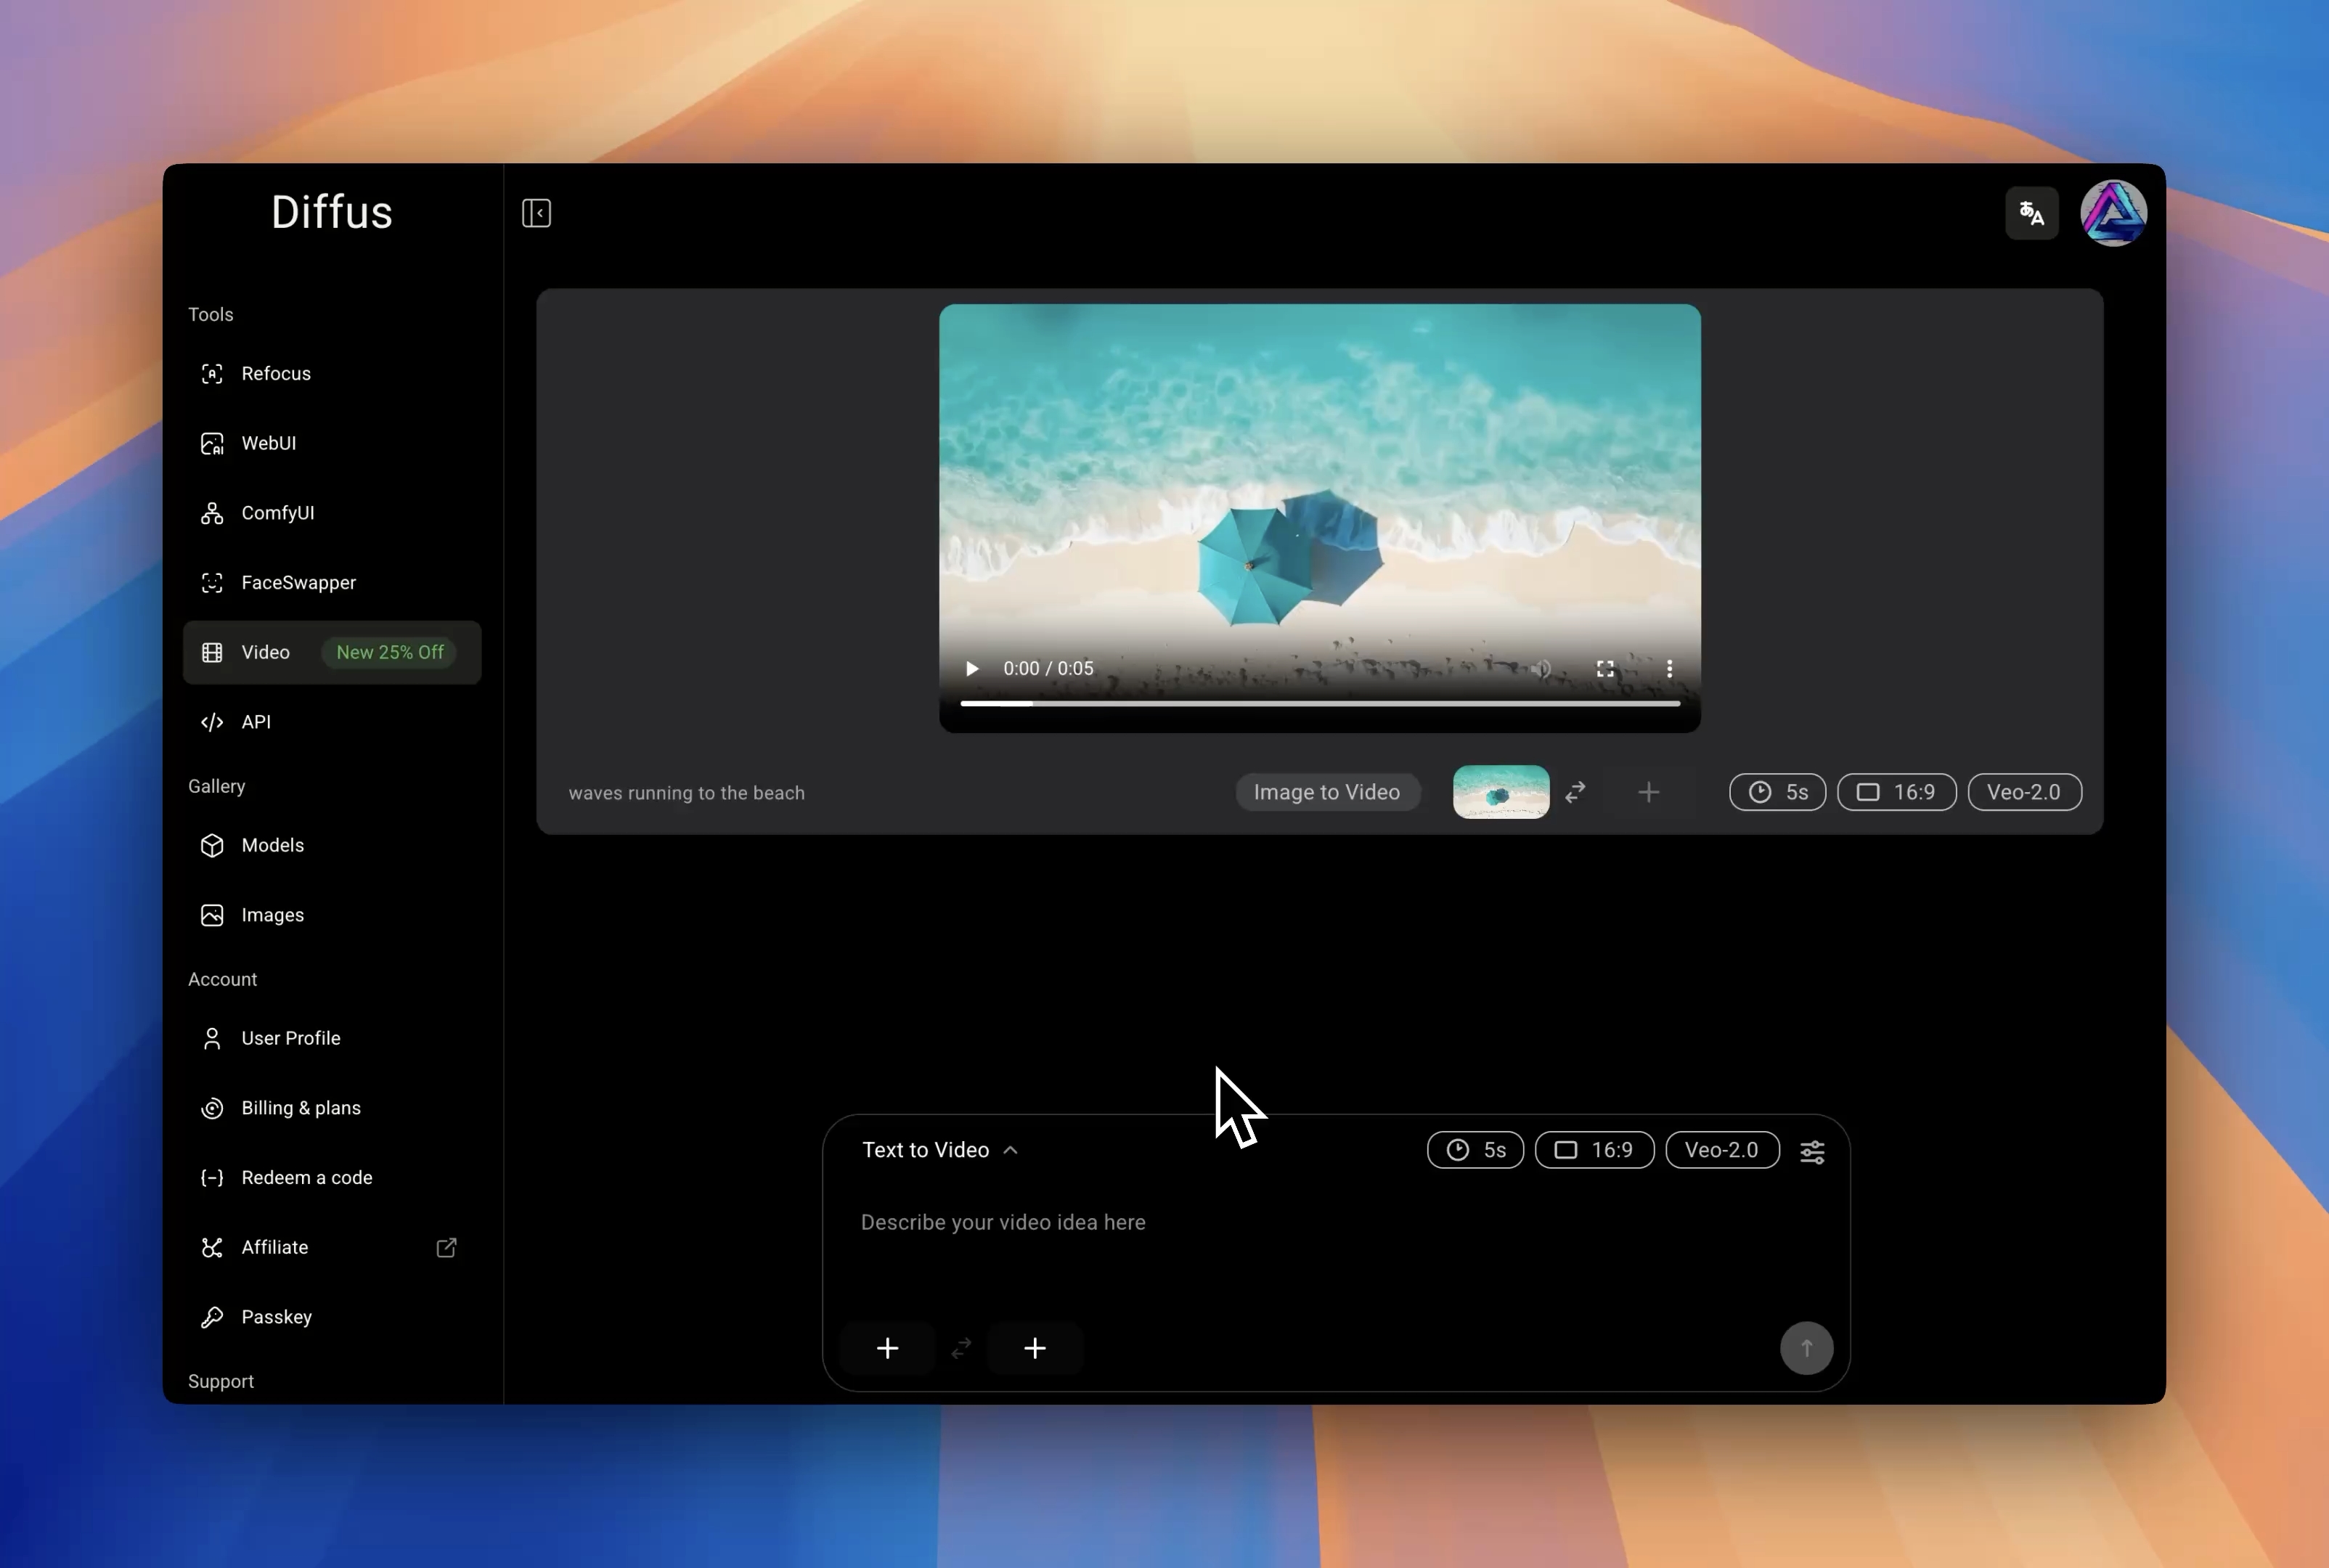
Ustawienia, które generator udostępnia dla tego modelu.
Cała scena, nie fragment
Trzydzieści sekund wystarczy, żeby ujęcie odetchnęło — najazd, pauza, rozwiązanie — bez cięcia między osobnymi generowaniami, które nigdy do końca do siebie nie pasują.
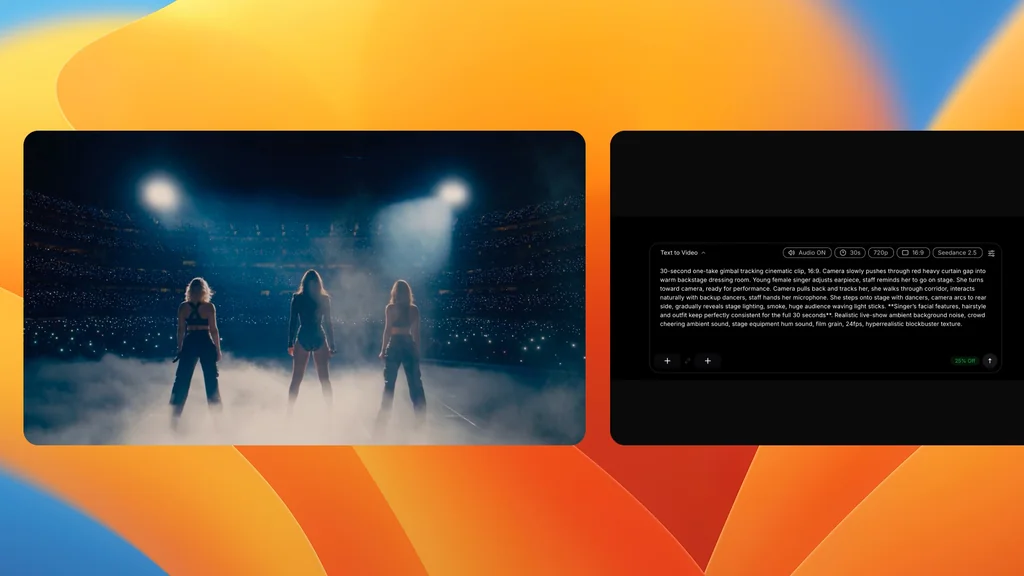
Przynieś swoją obsadę i swój styl
Podaj do 30 obrazów referencyjnych plus referencje audio i wideo, i zachowaj spójność postaci, kostiumów i kolorystyki w całym klipie.
Dźwięk, który przychodzi razem z obrazem
Dźwięk powstaje razem z obrazem, a nie jest nakładany później, więc klip nadaje się do użycia od razu po zakończeniu.
Jak to działa
Trzy kroki do klipu
Bez instalacji, bez GPU, bez rejestracji u każdego dostawcy.
Jedna pozycja na liście modeli, obok siedemnastu innych.
Prompt, pojedyncza klatka lub do 30 referencji dla sceny, która musi pozostać spójna.
Od 4 do 30 sekund, z dźwiękiem, w potrzebnych proporcjach.
Wybierz Seedance 2.5
Opisz to albo pokaż
Ustaw długość i generuj
Więcej darmowych narzędzi do wypróbowania
Narzędzia do jednego zadania, bez konfiguracji. Opisz, kliknij, gotowe.
Generator wideo AI
Wszystkie modele wideo na jednej stronie — wybierz ten, który pasuje do ujęcia.
Stworzone na Diffus
Klipy od społeczności, z modelem i promptem, który za nimi stoi.
Seedance 2.5 na Diffus — najczęstsze pytania
Daj ujęciu trzydzieści sekund
Jedna subskrypcja, osiemnaście modeli wideo, bez sprzętu.
18 modeli
Jedna subskrypcja

