Anime Illust Diffusion XL - v0.61
Palabras Clave y Etiquetas Relacionadas
Imágenes destacadas



Prompts Recomendados
Trigger word (by xxx),a girl named frieren from sousou no frieren series,best quality,beautiful color,detailed,aesthetic,impasto style,cowboy shot,fantasy theme,gradient background,sitting on ground,expressionless,white hair,twintails,green eyes,parted lip,white dress,frills,a cat,grass,sunshine
best quality, 1girl, solo, looking at viewer, bangs
Prompts Negativos Recomendados
(worst quality:1.3),low quality,lowres,messy,abstract,ugly,disfigured,bad anatomy,draft,deformed hands,fused fingers,signature,text,multi views
aidxlv05_neg
Parámetros Recomendados
samplers
steps
cfg
resolution
vae
Parámetros Recomendados de Alta Resolución
denoising strength
Consejos
Reduce el peso para palabras disparadoras de estilo de artista, por ejemplo, (by xxx:0.6).
Ordenar las etiquetas del prompt ayuda al modelo a entender mejor el significado; se proporciona un orden recomendado de etiquetas.
Usa 'refinar' (image2image o inpainting) si las salidas de texto a imagen están borrosas.
Para la fusión de estilos, controla el peso y el orden de los estilos y añade palabras de estilo al final en lugar de al principio.
Las palabras disparadoras de personajes usualmente no incluyen ropa; añade las etiquetas de ropa por separado.
Usa embeddings negativos especializados para el modelo en versiones 0.61 y anteriores para mejores resultados.
Asegúrate de que el total de píxeles se aproxime a 1024x1024 y que las dimensiones sean múltiplos de 32 para una generación óptima.
Aspectos Destacados de la Versión
Estilización más fuerte.
Además, añadí ruido adicional en el entrenamiento. Algunos muestreadores no llegan a tiempo cero en el paso final, lo que podría causar que la imagen generada tenga ruido. Por eso, Euler A o Euler sampler podrían ser más adecuados para usar.
风格化更明显。
另外,我在训练中使用了附加噪声。部分采样器的最终时间步不会归零,因此可能导致生成的图像带有噪声。因此,Euler A 或 Euler 采样器可能更适合您使用。
Patrocinadores del Creador
Si te gusta nuestro trabajo, apóyanos en Ko-fi: https://ko-fi.com/eugeai
Gracias a la comunidad @NieTa (nieta.art) por proveer potencia computacional, y a @KirinTea_Aki (perfil en Civitai) y @Chenkin (perfil en Civitai) por soporte de datos.
Introducción del Modelo (Parte en inglés)
I Contenido
En esta introducción, aprenderás sobre:
Información del modelo (ver Sección II);
Instrucciones de uso (ver Sección III);
Parámetros de entrenamiento (ver Sección IV);
Lista de Palabras Disparadoras (ver Apéndice Parte A)
II AIDXL
Anime Illustration Diffusion XL, o AIDXL, es un modelo dedicado a generar ilustraciones de anime estilizadas. Tiene más de 800 (con actualizaciones continuas) estilos de ilustración integrados, que se activan con palabras disparadoras específicas (ver Apéndice A).
Ventajas:
Composición flexible en lugar de poses tradicionales de IA.
Detalles hábiles en lugar de caos desordenado.
Conocimiento avanzado de personajes de anime.
III Guía de Usuario
1 Uso básico
1.1 Prompt
Palabras disparadoras: Añade las palabras disparadoras proporcionadas en el Apéndice A para estilizar la imagen. Las palabras disparadoras adecuadas mejorarán enormemente la calidad;
Se recomienda reducir el peso de las palabras disparadoras de estilo de artista, por ejemplo (by xxx:0.6).
Orden semántico: Ordenar las etiquetas o frases de tu prompt ayudará al modelo a entender mejor tu intención.
Orden recomendado de etiquetas: Palabra disparadora (by xxx) -> personaje (una chica llamada frieren de la serie sousou no frieren) -> raza (elfo) -> composición (plano cowboy) -> estilo (impasto ) -> tema (fantasía) -> ambiente principal (en el bosque, de día) -> fondo (fondo degradado) -> acción (sentada en el suelo) -> expresión (sin expresión) -> características principales (pelo blanco) -> características corporales (coletas, ojos verdes, labio partido) -> ropa (vestido blanco) -> accesorios de ropa (volantes) -> otros objetos (un gato) -> ambiente secundario (césped, luz solar) -> estética (color hermoso, detallado, estético) -> calidad ((mejor calidad:1.3))
Prompts negativos: (peor calidad:1.3), baja calidad, baja resolución, desordenado, abstracto, feo, deformado, mala anatomía, borrador, manos deformes, dedos fusionados, firma, texto, múltiples vistas
1.2 Parámetros de generación
Resolución: Asegúrate de que el número total de píxeles (=ancho * alto) sea alrededor de 1024*1024 y el ancho y alto sean divisibles por 32, en cuyo caso AIDXL producirá el mejor resultado. Por ejemplo, 832x1216 (2:3), 1216x832 (3:2) y 1024x1024 (1:1), etc.
Muestreador y pasos: Usa el muestreador "Euler Ancester", conocido como Euler A en webui. Muestrea alrededor de ~28 pasos con escala CFG entre 7 a 9.
'Refinar': La imagen generada de texto a imagen a veces está borrosa, en cuyo caso debes 'refinarla' usando image2image o inpainting, etc.
Para un simple escalado, puedes consultar: Escalar a tamaños enormes y añadir detalle con SD Upscale, es fácil! : r/StableDiffusion (reddit.com)
Otros componentes: No es necesario usar ningún modelo refiner. Usa el VAE del propio modelo o el
sdxl-vae.
Q: ¿Cómo reproducir la portada del modelo? ¿Por qué no puedo reproducir la misma imagen usando los mismos parámetros de generación?
A: Porque los parámetros de generación mostrados en la portada NO son los parámetros de texto a imagen, sino los de imagen a imagen (para escalar). La imagen base se genera mayormente con el muestreador Euler Ancester, no con el muestreador DPM.
2 Uso especial
2.1 Estilos generalizados
Desde la versión 0.7, AIDXL resume varios estilos similares e introduce palabras disparadoras de estilos generalizados. Estas palabras representan cada una una categoría común de estilo de ilustración animada. Ten en cuenta que las palabras disparadoras de estilo general no necesariamente corresponden al significado artístico de la palabra sino que son palabras disparadoras especialmente redefinidas.
2.2 Personajes
Desde la versión 0.7, AIDXL ha mejorado el entrenamiento para personajes. El efecto de algunas palabras disparadoras de personajes puede ya alcanzar el efecto de Lora, y puede separar bien el concepto del personaje de su propia ropa.
El método para activar personajes es: {personaje} \({derechos de autor}\). Por ejemplo, para activar la heroína Lucy en la animación "Cyberpunk: Edgerunners", usa lucy \(cyberpunk\); para activar al personaje Gan Yu en el juego "Genshin Impact", usa ganyu \(genshin impact\). Aquí, "lucy" y "ganyu" son nombres de personajes, "\(cyberpunk\)" y "\(genshin impact\)" son los orígenes respectivos y los paréntesis se escapan con barras "\" para evitar ser interpretados como etiquetas con peso. Para algunos personajes, la parte de derechos de autor no es necesaria.
Desde la versión v0.8, existe otro método de disparo más fácil: una {chica/chico} llamada {personaje} de la serie {derechos de autor}.
Para la lista de palabras disparadoras de personajes, consulta: selected_tags.csv · SmilingWolf/wd-v1-4-convnext-tagger-v2 en main (huggingface.co). Además, algunas palabras disparadoras adicionales que no se mencionan en este documento pueden incluirse.
Algunos personajes requieren un paso extra de activación. Si al usarlos con una sola palabra disparadora no se restauran completamente, se debe añadir al prompt las características principales del personaje.
AIDXL soporta cambio de vestuario de personajes. Las palabras disparadoras de personajes normalmente no incluyen la característica de vestimenta del mismo. Si quieres agregar ropa de personaje, debes añadir la etiqueta de ropa en el prompt. Por ejemplo, vestido de noche plateado, escote profundo para el vestido del personaje St. Louis (Luxurious Wheels) del juego Azur Lane. De manera similar, puedes añadir etiquetas de vestimenta de cualquier personaje a otros personajes.
2.3 Etiquetas de calidad
Calidad y etiquetas estéticas están formalmente entrenadas. Usarlas en los prompts afecta la calidad de la imagen generada.
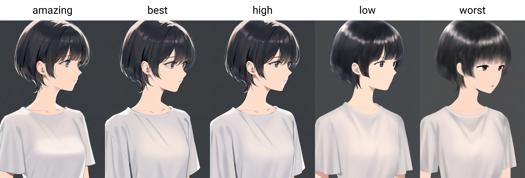
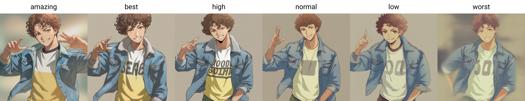
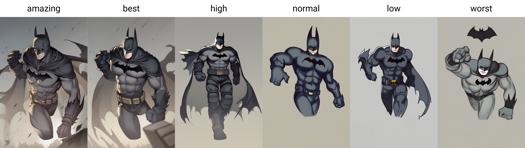
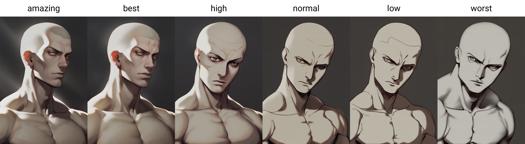
Desde la versión 0.7, AIDXL entrena e introduce oficialmente etiquetas de calidad. Las calidades se dividen en seis niveles, de mejor a peor: amazing quality, best quality, high quality, normal quality, low quality y worst quality.
Se recomienda añadir peso extra a las etiquetas de calidad, por ejemplo (amazing quality:1.5).
2.4 Etiquetas estéticas
Desde la versión 0.7 se introdujeron etiquetas estéticas para describir características estéticas especiales de las imágenes.
2.5 Fusión de estilos
Puedes fusionar algunos estilos en tu estilo personalizado. 'Fusionar' significa usar varias palabras disparadoras de estilo a la vez. Por ejemplo, chun-li, amazing quality, (by yoneyama mai:0.9), (by chi4:0.8), by ask, by modare, (by ikky:0.9).
Algunos consejos:
Controla el peso y el orden de los estilos para ajustar el estilo.
Añade al final en lugar de al principio de tu prompt.
IV Estrategia y parámetros de entrenamiento
AIDXLv0.1
Usando SDXL1.0 como modelo base, con unas 22k imágenes etiquetadas para entrenar aproximadamente 100 epochs con un programador coseno y tasa de aprendizaje de 5e-6 y un número de ciclos = 1 para obtener el modelo A. Luego, usando una tasa de aprendizaje de 2e-7 y los mismos demás parámetros para obtener el modelo B. El modelo AIDXLv0.1 se obtiene fusionando los modelos A y B.
AIDXLv0.51
Estrategia de Entrenamiento
Se retoma el entrenamiento desde AIDXLv0.5, con tres fases de entrenamiento consecutivas:
Entrenamiento con leyendas largas: Usa todo el dataset, con algunas imágenes etiquetadas manualmente. Entrena tanto U-Net como el codificador de texto con el optimizador AdamW8bit, una tasa de aprendizaje alta (alrededor de 1.5e-6) con programador coseno. Detén el entrenamiento cuando la tasa baja del umbral (alrededor de 5e-7).
Entrenamiento con leyendas cortas: Reiniciar entrenamiento desde el resultado del paso 1 con los mismos parámetros y estrategia pero con un dataset con leyendas más cortas.
Paso de refinamiento: Prepara un subconjunto del dataset del paso 1 que contiene imágenes de alta calidad seleccionadas manualmente. Reinicia entrenamiento desde el paso 2 con tasa de aprendizaje baja (alrededor de 7.5e-7), con programador coseno con reinicios de 5 a 10 vueltas. Entrena hasta que el resultado sea estéticamente bueno.
Parámetros fijos de entrenamiento
No se añade ruido extra ni desplazamiento de ruido.
Gamma min snr = 5: acelera el entrenamiento.
Precisión completa bf16.
Optimizador AdamW8bit: equilibrio entre eficiencia y rendimiento.
Dataset
Resolución: 1024x1024 resolución total (= alto x ancho) con estrategia modificada oficial de buckets SDXL.
Etiquetado: Etiquetado por modelo WD14-Swinv2 con umbral 0.35.
Recorte close-up: Recortar imágenes en varios close-ups. Muy útil cuando las imágenes de entrenamiento son grandes o raras.
Palabras disparadoras: Mantener la primera etiqueta de las imágenes como palabra disparadora.
AIDXLv0.6
Estrategia de Entrenamiento
Se retoma el entrenamiento desde AIDXLv0.52, pero con estrategia adaptativa de repeticiones - Para cada imagen etiquetada en el dataset, se incrementa su número de repeticiones en el entrenamiento sujeto a las siguientes reglas:
Regla 1: Cuanto mayor sea la calidad de la imagen, más repeticiones tendrá;
Regla 2: Si la imagen pertenece a una clase de estilo:
Si la clase no está ajustada o está subajustada, se incrementan manualmente las repeticiones de la clase, o se aumentan automáticamente las repeticiones para que el total de repeticiones alcance un valor preestablecido, alrededor de 100.
Si la clase ya está ajustada o está sobreajustada, se disminuyen manualmente las repeticiones de la clase forzando a 1 y se descarta si su calidad es baja.
Regla 3: Su número de repeticiones limita el número final para que no supere cierto umbral, alrededor de 10.
Esta estrategia tiene las siguientes ventajas:
Protege la información original del modelo ante nuevo entrenamiento, siguiendo la idea de imagen regularizada;
Hace más controlable el impacto de los datos de entrenamiento;
Equilibra el entrenamiento entre diferentes clases motivando las clases no ajustadas y previniendo sobreajuste en las ya ajustadas;
Ahorra significativamente recursos computacionales y facilita añadir nuevos estilos al modelo.
Parámetros fijos de entrenamiento
Iguales que en AIDXLv0.51.
Dataset
El dataset de AIDXLv0.6 se basa en AIDXLv0.51 y además aplica las siguientes optimizaciones:
Orden semántico de etiquetas: Ordena las etiquetas de las leyendas por orden semántico, por ejemplo "gun, 1boy, holding, short hair" -> "1boy, short hair, holding, gun".
Eliminación de duplicados en etiquetas: Elimina etiquetas duplicadas, conservando la que retiene más información. Las etiquetas duplicadas son etiquetas con significado similar como "pelo largo" y "pelo muy largo".
Etiquetas extras: Añade manualmente etiquetas adicionales a todas las imágenes, por ejemplo "alta calidad", "impasto", etc. Esto se puede hacer rápidamente con algunas herramientas.
V Agradecimientos especiales
Patrocinio de potencia computacional: Gracias a la comunidad @NieTa (捏Ta (nieta.art)) por proveer soporte de potencia computacional;
Soporte de datos: Gracias a @KirinTea_Aki (Perfil de creador KirinTea_Aki | Civitai) y a @Chenkin (Perfil de creador Chenkin | Civitai) por proveer gran cantidad de soporte de datos;
No existiría la versión 0.7 sin ellos.
VI AIDXL vs AID
2023/08/08. AIDXL fue entrenado con el mismo conjunto de entrenamiento que AIDv2.10, pero supera a AIDv2.10. AIDXL es más inteligente y puede hacer muchas cosas que modelos basados en SD1.5 no pueden. También realiza un excelente trabajo distinguiendo conceptos, aprendiendo detalles de la imagen y manejando composiciones difíciles o imposibles para SD1.5 y AID. En general, tiene un potencial absoluto. Continuaré actualizando AIDXL.
VII Patrocinio
Si te gusta nuestro trabajo, puedes patrocinarnos a través de Ko-fi(https://ko-fi.com/eugeai) para apoyar nuestra investigación y desarrollo. ¡Gracias por tu apoyo~
Introducción del Modelo (Parte en chino)
I Contenido
En esta introducción, podrás aprender sobre:
Introducción del modelo (ver sección II);
Guía de uso (ver sección III);
Parámetros de entrenamiento (ver sección IV);
Lista de palabras disparadoras (ver apéndice A)
II Introducción del modelo
Anime Illustration Diffusion XL, o AIDXL, es un modelo especializado para generar ilustraciones de anime. Tiene incorporados más de 800 estilos de ilustración (con actualizaciones continuas), activados mediante palabras disparadoras específicas (ver apéndice A).
Ventajas: composición audaz sin sensación de pose forzada, protagonista destacado, sin detalles excesivos, reconocimiento de numerosos personajes de anime (activado por nombres japoneses en pinyin, por ejemplo, “ayanami rei” para el personaje “绫波丽”, “kamado nezuko” para “祢豆子”).
III Guía de uso (actualizable)
1 Uso básico
1.1 Escritura del prompt
Usar palabras disparadoras: usa las palabras disparadoras proporcionadas en el apéndice A para estilizar la imagen. Palabras disparadoras adecuadas mejoran significativamente la calidad;
Etiquetado del prompt: usa tags en el prompt para describir el objeto a generar;
Ordenar el prompt: ordenar tus palabras disparadoras ayuda al modelo a entender mejor el significado. Orden recomendado:
palabras disparadoras (by xxx)->protagonista (1girl)->personaje (frieren)->raza (elfo)->composición (cowboy shot)->estilo (impasto)->tema (fantasía)->ambiente principal (bosque, día)->fondo (fondo degradado)->acción (sentada)->expresión (sin expresión)->característica principal del personaje (pelo blanco)->características corporales (coletas, ojos verdes, labio partido)->ropa (vestido blanco)->accesorios de ropa (volantes)->otros objetos (varita mágica)->ambiente secundario (césped, luz solar)->estética (color hermoso, detallado, estético)->calidad (mejor calidad)
Prompts negativos: peor calidad, baja calidad, baja resolución, desordenado, abstracto, feo, deformado, mala anatomía, manos deformes, dedos fusionados, firma, texto, múltiples vistas
1.2 Parámetros de generación
Resolución: asegúrate de que la resolución total (alto x ancho) sea alrededor de 1024x1024 y que el ancho y alto sean múltiplos de 32. Por ejemplo, 832x1216 (3:2), 1216x832 (3:2), y 1024x1024 (1:1).
No uses la operación “Clip Skip”, es decir, Clip Skip = 1.
Muestreador y pasos: usa el muestreador “euler_ancester” (llamado Euler A en webui). Muestrea 28 pasos con escala CFG 7.
No es necesario usar refiner.
Usa el VAE base del modelo o sdxl-vae.
2 Uso especial
2.1 Estilización generalizada
En la versión 0.7 se agruparon varios estilos similares y se introdujeron palabras disparadoras generales. Cada una representa una categoría común de estilo de ilustración de anime.
Nota que las palabras disparadoras generales no necesariamente coinciden con el significado artístico de su palabra sino que son palabras especializadas redefinidas.
2.2 Personajes
La versión 0.7 mejoró el entrenamiento para personajes. Algunas palabras disparadoras ya logran el efecto de Lora y pueden separar bien el concepto del personaje de su ropa propia.
La forma de activar personajes es nombre_personaje \(obra\). Ejemplo: para activar a Lucy en la animación "Cyberpunk: Edgerunners" usa lucy \(cyberpunk\); para activar a Gan Yu en el juego "Genshin Impact", usa ganyu \(genshin impact\). Aquí, "lucy" y "ganyu" son nombres, y "\(cyberpunk\)" y "\(genshin impact\)" son obras respectivas, con paréntesis escapados con "\" para evitar ser interpretados como etiquetas ponderadas. Para algunos personajes no es necesario indicar la obra.
Consulta selected_tags.csv · SmilingWolf/wd-v1-4-convnext-tagger-v2 para la lista de palabras disparadoras.
Si un personaje no se representa completamente con una sola palabra disparadora, añade sus características principales en el prompt.
Las palabras disparadoras de personajes generalmente no incluyen prendas. Si quieres añadir ropa, añádela en el prompt. Por ejemplo, para el vestido de St. Louis (Luxurious Wheels) en el juego Azur Lane, usa silver evening gown, plunging neckline. Puedes mezclar etiquetas de ropa de un personaje con otros.
2.3 Etiquetas de calidad
Las etiquetas de calidad y estética están entrenadas formalmente. Añadirlas en el prompt afecta la calidad.
Desde la versión 0.7, se introdujeron seis niveles de calidad, de mejor a peor: amazing quality, best quality, high quality, normal quality, low quality, y worst quality.
Se recomienda añadir peso extra, e.g., (amazing quality:1.5).
2.4 Etiquetas estéticas
Desde la versión 0.7 se han introducido etiquetas estéticas para describir características especiales.
2.5 Fusión de estilos
Puedes fusionar estilos usando múltiples palabras disparadoras a la vez. Por ejemplo, chun-li, amazing quality, (by yoneyama mai:0.9), (by chi4:0.8), by ask, by modare, (by ikky:0.9).
Consejos:
Controla peso y orden de estilos para ajustar el resultado.
Añade al final del prompt, no al principio.
3 Precauciones
Usa modelos VAE, embeddings y Lora compatibles con SDXL. Nota: sd-vae-ft-mse-original no es compatible con SDXL; EasyNegative, badhandv4 y embeddings negativos similares tampoco lo son.
Para versión 0.61 y anteriores: al generar imágenes, se recomienda fuertemente usar embeddings de texto negativos específicos para el modelo (disponibles en la sección Recursos Sugeridos), pues están hechos para el modelo y proporcionan efectos prácticamente solo positivos;
Las palabras disparadoras nuevas por versión suelen tener efectos débiles o inestables en esa versión.
IV Parámetros de entrenamiento
Partiendo de SDXL1.0, se usaron aproximadamente 20,000 imágenes etiquetadas para entrenar durante unas 100 épocas con tasa de aprendizaje 5e-6 y scheduler coseno con 1 ciclo para obtener el modelo A. Luego, a tasa 2e-7 y mismos otros parámetros se entrenó el modelo B. Finalmente, combinaron los modelos A y B para obtener AIDXLv0.1.
Otros parámetros de entrenamiento consulta la versión en inglés.
V Agradecimientos especiales
Patrocinio de potencia computacional: gracias a la comunidad @NieTa (捏Ta (nieta.art)) por el soporte de potencia computacional;
Soporte de datos: gracias a @秋麒麟热茶 (Perfil de creador KirinTea_Aki | Civitai) y @风吟 (Perfil de creador Chenkin | Civitai) por proporcionar una gran cantidad de soporte de datos;
Sin ellos no habría versión 0.7.
VI Registro de cambios
2023/08/08: AIDXL fue entrenado con el mismo conjunto que AIDv2.10 pero supera su rendimiento. AIDXL es más inteligente y puede hacer muchas cosas que los modelos basados en SD1.5 no pueden. También distingue mejor los conceptos, aprende detalles y maneja composiciones difíciles para SD1.5 y AID. En general, tiene un nivel superior; seguiré actualizando AIDXL.
2024/01/27: La versión 0.7 añadió gran cantidad de contenido y el tamaño del dataset es más del doble que la versión anterior.
Para obtener anotaciones satisfactorias, se probaron muchos nuevos algoritmos de procesamiento de etiquetas como ordenación, estratificación y separación de características de personajes. Proyecto en: Eugeoter/sd-dataset-manager (github.com);
Para controlar el entrenamiento y hacer que siga mi voluntad, desarrollé scripts especiales basados en Kohya-ss;
Para controlar el proceso de fusión de modelos de diferentes generaciones, desarrollé heurísticos para la fusión y descarté la fusión directa de capas OUT del codificador de texto y UNET para favorecer la estilización del modelo;
Para filtrar datos, entrené un modelo de detección de marcas de agua, clasificación de imágenes y puntuación estética para limpiar los datos.
VII Patrocínanos
Si te gusta nuestro trabajo, te invitamos a apoyarnos a través de Ko-fi(https://ko-fi.com/eugeai) para sustentar nuestra investigación y desarrollo. ¡Gracias por tu apoyo!
Apéndice / 附录
A. Lista de Palabras Disparadoras Especiales / 特殊触发词列表
Palabras disparadoras de estilo artístico: Haz clic aquí
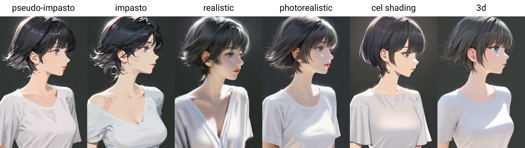
Palabras disparadoras de estilo de pintura: flat color, clean color, celluloid, flat-pasto, thin-pasto, pseudo-impasto, impasto, realistic, photorealistic, cel shading, 3d
flat color: colores planos, usando líneas para describir luz y sombra
平涂:colores planos, usando líneas y bloques de color para describir luz y capas
clean color: estilo entre flat color y flat-pasto. Coloración sencilla y ordenada.
色彩 limpia: estilo entre flat color y flat-pasto. Coloreado simple y limpio.
celluloid: coloreado de anime
赛璐璐: coloreado de anime
flat-pasto: color casi plano, usando gradientes para describir luces y sombras
flat-pasto: color casi plano, usando degradados para describir luces y sombras
thin-pasto: contorno delgado, usando gradientes y grosor de pintura para describir luz, sombra y capas
thin-pasto: contorno fino, usando gradientes y grosor de pintura para describir luz, sombra y capas
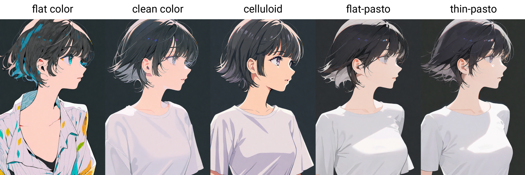
pseudo-impasto: usa gradientes y grosor de pintura para describir luz, sombra y capas
semi-impasto / pseudo-impasto: usa gradientes y grosor de pintura para describir luz, sombra y capas
impasto: usa grosor de pintura para describir luz, sombra y gradación
impasto: usa grosor de pintura para describir luz, sombra y gradación
realistic
realista
photorealistic: redefinido como un estilo más cercano al mundo real
fotorrealista: redefinido como estilo más cercano al mundo real
cel shading: estilo de modelado 3D de anime
cel shading: estilo de modelado 3D para anime
3d
Palabras disparadoras estéticas:
beautiful
hermoso
aesthetic: sentido artístico ligeramente abstracto
estético: sentido artístico levemente abstracto
detailed
detallado
beautiful color: uso sutil del color
color armonioso: uso sutil del color
lowres
messy: composición o detalles desordenados
desordenado: composición o detalles caóticos
Palabras disparadoras de calidad: amazing quality, best quality, high quality, low quality, worst quality

Detalles del Modelo
Tipo de modelo
Modelo base
Versión del modelo
Hash del modelo
Palabras entrenadas
Creador

Discusión
Por favor log in para dejar un comentario.
Colección de Modelos - Anime Illust Diffusion XL

Imágenes por Anime Illust Diffusion XL - v0.61
Imágenes con anime
Imágenes con modelo base
Imágenes con color plano





Imágenes con ilustración