Seedream - v4.5
Mots-clés et tags associés
Images en vedette
Paramètres recommandés
resolution
Conseils
Utilisez le guide officiel pour exploiter Seedream 4.5 disponible chez Bytedance pour de meilleurs résultats.
Profitez des solides capacités de rendu de texte du modèle pour les petites polices et la typographie complexe.
Bénéficiez de l'inférence rapide pour générer rapidement des images haute résolution.
Sponsors du créateur
Seedream 4.5 - désormais avec une résolution 4k sans coût supplémentaire !
Découvrez le guide officiel extrêmement utile pour exploiter Seedream 4.5, par Bytedance !
Détails initialement publiés sur : https://seed.bytedance.com/en/tech/seedream3_0
Innovation technique
Comparé à notre modèle précédent Seedream 2.0, nous employons plusieurs stratégies innovantes pour relever les défis existants, notamment la limitation des résolutions d'image, la complexité du respect des attributs, la génération typographique fine, ainsi que l'esthétique et la fidélité visuelle sous-optimales.
Cela se traduit principalement par les quatre points suivants :
• Au niveau des données, l'échelle du dataset a été doublée grâce à un nouveau mécanisme d'échantillonnage dynamique opérant selon deux axes orthogonaux : la distribution des clusters d'images et la cohérence sémantique textuelle.
• Lors de la phase de pré-entraînement, nous mettons en œuvre plusieurs améliorations par rapport à la version 2.0, offrant une meilleure scalabilité, généralisabilité et alignement visuel-langage : i) Entraînement à résolution mixte ; ii) RoPE multimodal ; iii) Perte d'alignement des représentations ; iv) Échantillonnage temporel conscient de la résolution.
• Pendant l'optimisation post-entraînement, nous utilisons des légendes esthétiques diversifiées et un modèle de récompense basé sur VLM pour améliorer davantage les capacités globales du modèle.
• En accélération du modèle, nous favorisons un échantillonnage stable via une attente de bruit cohérente, réduisant efficacement le nombre d'évaluations de fonctions (NFE) en inférence.
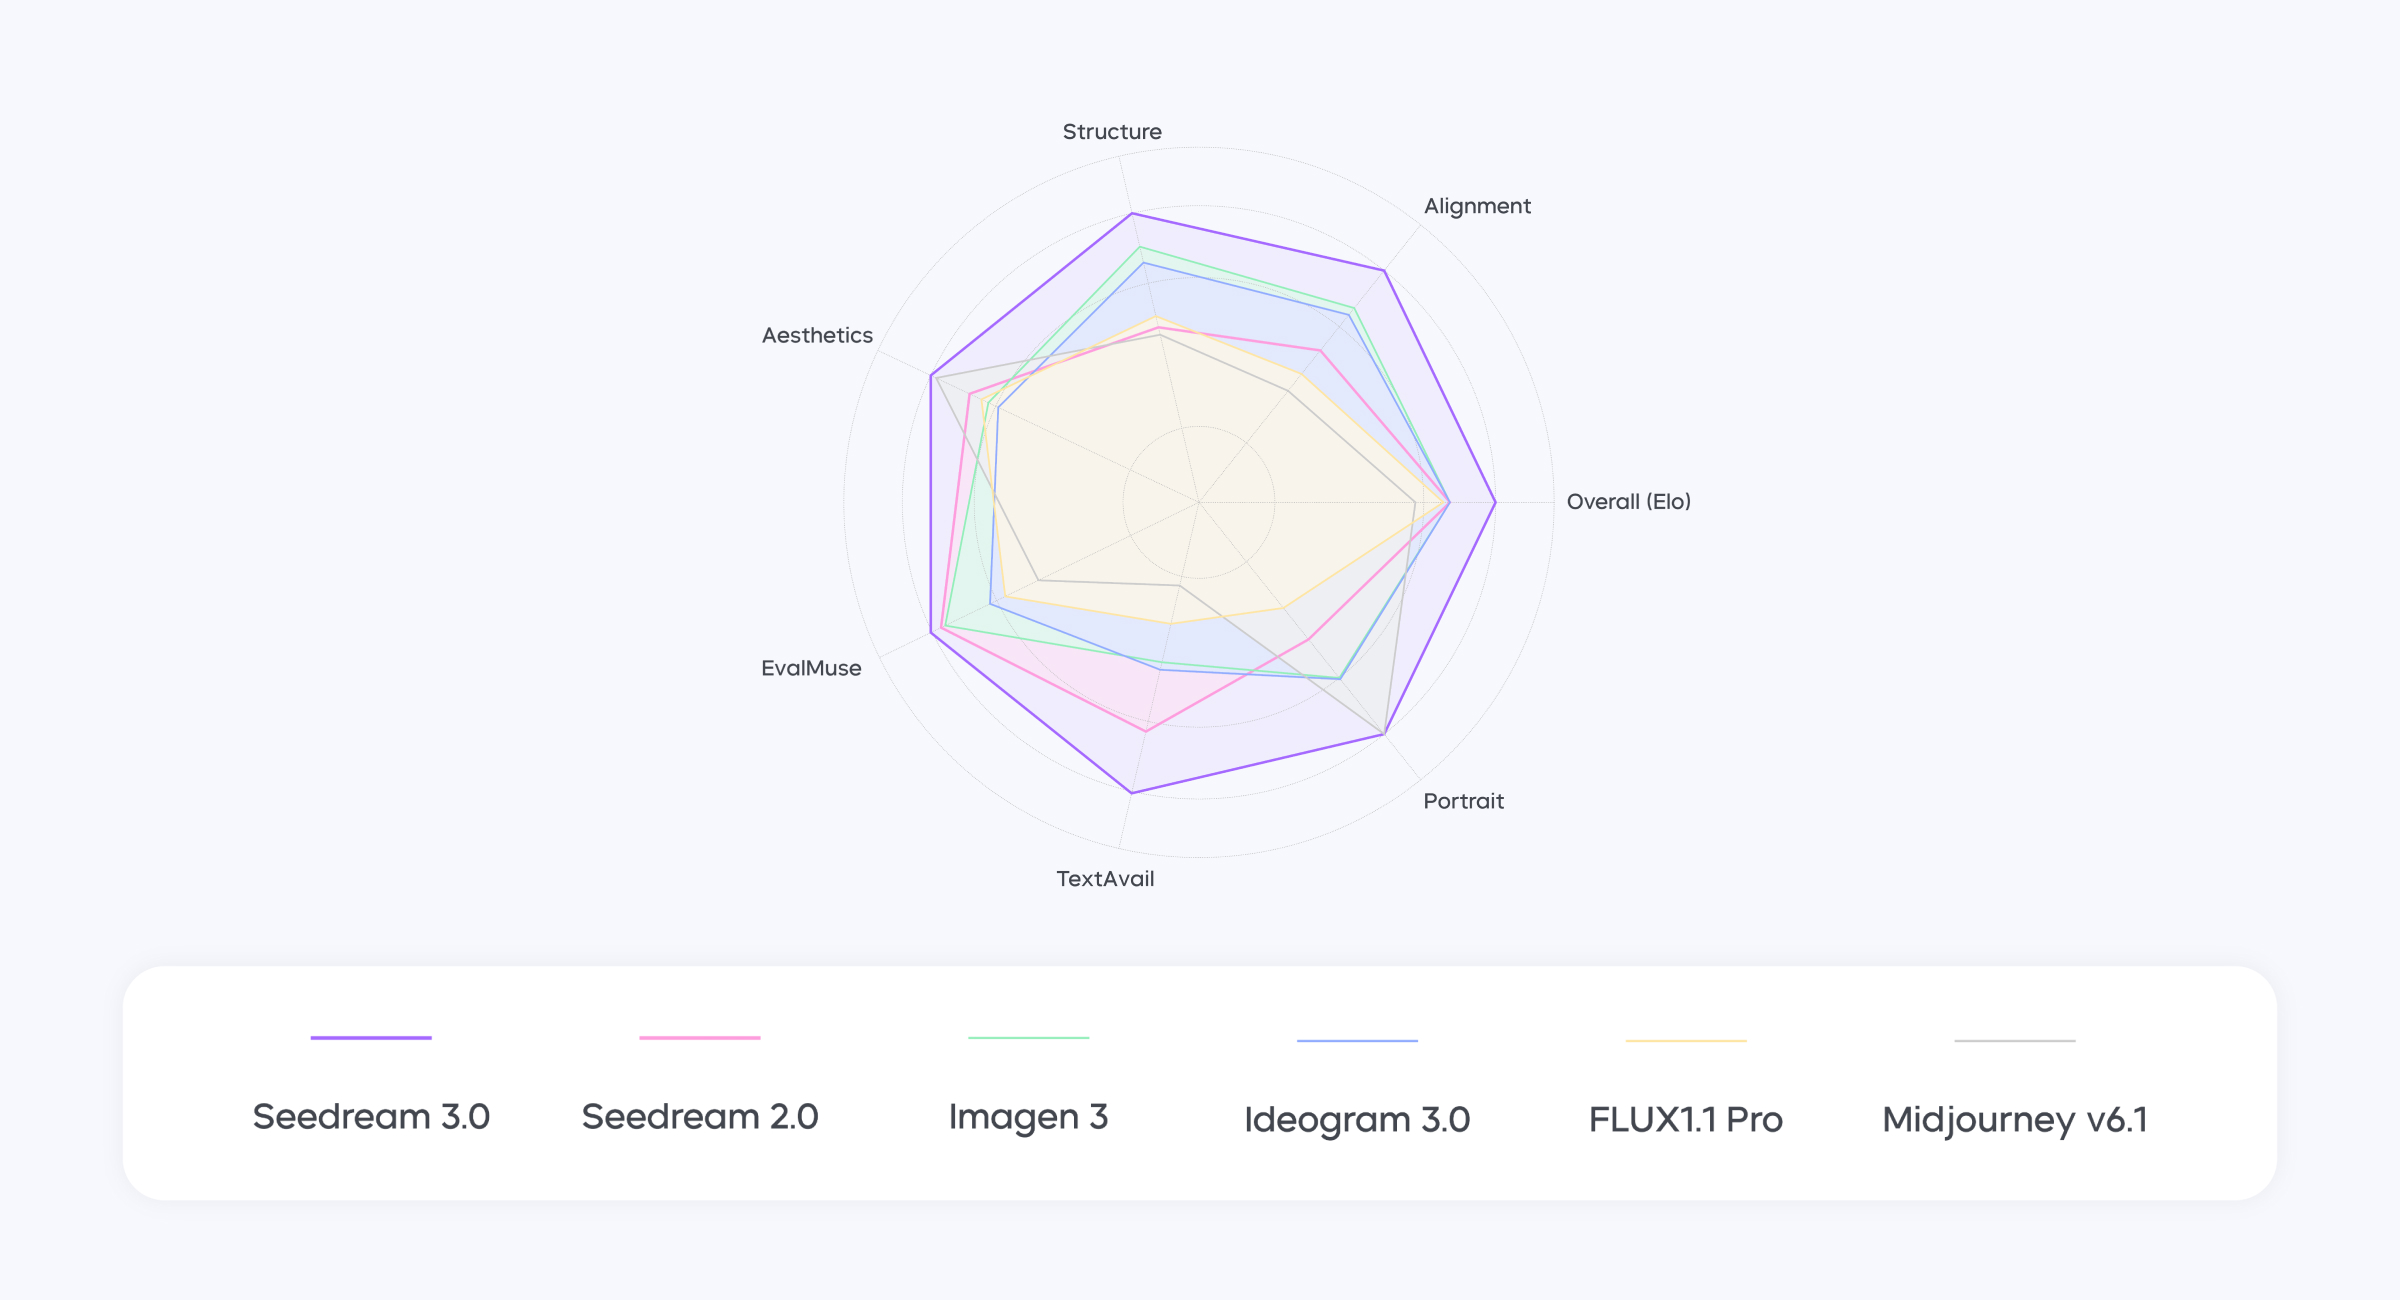
Figure 1 Seedream 3.0 se classe premier au Classement de l'Arène d'Analyse d'Images Artificielles. En raison de données manquantes, le résultat Portrait pour Imagen 3 et le résultat global pour Seedream 2.0 sont représentés par la moyenne des autres modèles.
Performance itérative du modèle
Comparé à Seedream 2.0, Seedream 3.0 réalise des avancées significatives sur plusieurs dimensions :
• Résolution native élevée : prend en charge nativement une sortie en 2K sans post-traitement, tout en étant compatible avec des résolutions plus élevées et adaptable à divers rapports d'aspect.
• Améliorations globales des capacités : démontre des progrès significatifs dans l'alignement texte-image, la conception structurelle compositionnelle, la qualité esthétique et les capacités de rendu de texte.
• Améliorations notables des performances de rendu de texte : excelle dans la génération de petites polices, la précision des caractères chinois et la mise en page longue de haute esthétique. Le modèle relève les défis industriels liés à la génération de petits textes et à la mise en page de longs textes, avec des rendus graphiques surpassant les modèles manuellement conçus par des plateformes telles que Canva. Grâce à une génération de texte précise et esthétiquement raffinée, il permet la création facile d'affiches de niveau designer, intégrant harmonieusement diverses polices, styles et mises en page.
• Améliorations esthétiques : obtient des améliorations marquées de la qualité esthétique des images, offrant une forte performance dans le rendu de scènes cinématographiques et générant des portraits avec des textures plus réalistes.
• Expérience de génération ultra-rapide : grâce à plusieurs technologies d'accélération innovantes, les coûts d'inférence sont considérablement réduits. La génération complète d'images en 1K résolution ne prend plus que 3,0 secondes.
Figure 2 Résultats d'évaluation humaine. Seedream 3.0 surpasse les autres modèles en termes de correspondance image-texte, structure et esthétique.

Détails du modèle
Type de modèle
Modèle de base
Version du modèle
Hash du modèle
Créateur

Discussion
Veuillez vous log in pour laisser un commentaire.
Collection de modèles - Seedream
Images par Seedream - v4.5
Images avec modèle de base