MarblingTIXL - v2.0
Immagini in evidenza
Prompt Consigliati
award-winning Art Nouveau xlmrblng15-1300, analog realistic colour photo of a Japanese mermaid sitting on a rock in the midst of crashing waves, very detailed
cybernetic nun, xlmrblng15-1300
fantasy winter landscape, xlmrblng15-1300
(__Art_Movements__:0.5) xlmrblng15-1300, mature __Nationalities__ (__Character_MF__) riding a __BW_Animals__ in a white-tinted __Landscapes__, __Metal_Color__ filigree inlay
very detailed, intricate
Parametri Consigliati
samplers
steps
cfg
resolution
vae
other models
Parametri Consigliati per Alta Risoluzione
upscaler
upscale
steps
denoising strength
Suggerimenti
Usa da 3 a 5 token prima del token TI (es. 'portrait of a woman, xlmrblng15-1300') per ottenere risultati migliori.
I migliori risultati si ottengono con prompt tra 30 e 45 token senza prompt negativi.
Evita di usare parole trigger TI che sovrappongono concetti noti SDXL (come 'marbling'), poiché causa risultati inaspettati.
Usa il sistema wildcard di Dynamic Prompts per un prompting vario e creativo.
L’addestramento con kohya_ss richiede una scelta attenta della parola iniziale; usa 'pattern' per il miglior equilibrio ed evitare motivi ripetitivi.
Il TI consiste in 8 vettori per un effetto maggiore, sovradimensionato per prompt brevi/semplici.
Usa sampler come DPM++ 2M Karras con CFG 7 e 40 passi per la generazione.
Risoluzioni vicine a 1MP (1024x1024, 960x1344, 1344x960) offrono buona qualità; 1344x960 è perfetto per stampe 7"x5".
Punti Salienti della Versione
Questa è una nuova versione con l’attuale kohya_ss (v22.6.0 al momento della scrittura) dato che le impostazioni usate con la versione vecchia non producono gli stessi risultati. Sono inclusi i dati di addestramento e note per chi fosse interessato. L’addestramento ha usato accumulo di gradiente = 4, quindi i 500 passi sono simili a 2000 passi senza accumulo.
31 gen 2024
v2.0 non è una versione migliore di MarblingTIXL. Solo diversa. v1.0 funziona ancora bene.
Con i cambiamenti in kohya è emerso che il modo in cui ho creato la v1 di questo TI non funziona più, o almeno non produce nulla di molto utile.
Grazie a @raken per avermelo fatto sapere.
Penso ancora che ci sia un grande potenziale negli embedding SDXL, quindi ho fatto una nuova installazione di kohya_ss (v22.6.0 al momento della scrittura) e ho provato vari parametri/impostazioni finché non ho trovato una combinazione che crea un parente stretto dell'originale MarblingTIXL.
Nel caso a qualcuno interessino gli SDXL TI (e so che siete almeno in 2!), ho incluso i miei dati di addestramento e il file di configurazione JSON di kohya_ss. Possibilmente qualche nota se penso a qualcosa di utile.
Come vantaggio, questo TI si è addestrato più velocemente... come svantaggio non è così coerente come il TI precedente. O forse non ci ho giocato abbastanza. Chi può dirlo qui sull'avanguardia?!
Se qualcuno ha domande, osservazioni, opinioni o saggezza da condividere, per favore lasci un commento qui sotto. Al momento non sembra esserci molta info solida su come creare stili TI... Ho letto/guardato molti punti di vista contraddittori. Si può fare comunque, e penso che ci sia spazio per TI migliori di quelli che ho realizzato finora.
Concorrenza con LoRA? No, non proprio - le LoRA aggiungono qualcosa a un checkpoint mentre i TI sfruttano ciò che è già nel checkpoint. Se ho capito bene, i TI ti permettono di raggiungere aree nello spazio delle possibilità di un checkpoint che sarebbero difficili da raggiungere con costanza. Quindi TI e LoRA sono cose diverse per scopi diversi... che puoi usare insieme. Così tutti sono felici :-)
Ci sono articoli tecnici in giro (che spiegano cos’è un TI, come addestrarlo, argomenti sugli encoder di testo, ecc) ma di solito sono fuori dalla mia portata a metà della prima pagina :-(
Per quanto posso capire, kohya_ss addestra solo il primo TE (text encoder) in SDXL. Quello di SD v1.x che dovrebbe funzionare in auto1111 SDXL generation ma non lo fa. (Alcuni riportano che i TI di SD v1.x funzionano in Comfy, ma l’esperienza sembra variabile.) Per quanto posso capire il secondo TE non è addestrato in kohya_ss (è quello di SD v2.x). O forse è un duplicato del TE1?
Ho provato con OneTrainer (che ha opzioni per entrambi i TE) ma non ho avuto successo con i pochi tentativi fatti, quindi per ora resto con kohya_ss.
Per riferimento, uso una RTX-3060 con 12GB su un PC ragionevole. Gli attuali run di kohya_ss superano appena i 12GB (+ altri 6GB se genero campioni) perciò richiede più risorse rispetto a un LoRA. Pensavo che i TI ne avrebbero richieste meno (o uguali) quindi sono un po’ sorpreso. Forse non c’è necessità percepita di ottimizzare per i TI? Ancora :-)
Il TI qui è stato addestrato su:
sd_xl_base_1.0_0.9vae.safetensors
Le immagini di showcase sono state generate usando:
crystalClearXL_ccxl.safetensors [0b76532e03]
cioè un TI addestrato su base vanilla dovrebbe funzionare con altri checkpoint.
Le immagini sono generate in a1111 v1.7.0 e ho usato Hires.fix ma nessun altro aggiustatore.
La galleria aggiuntiva sotto mostra coppie senza/con così potete vedere come il TI influisce su prompt selezionati. L’etichetta “xlmrblnh36-500” significa senza, “xlmrblng36-500” significa con. L’ho fatto così per mantenere i due prompt il più simili possibile.
Se siete interessati, lo zip Training Data contiene tutti i TI salvati a intervalli di 25 passi (*4 accumulo gradiente = 100 passi normali).
- - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - -
NOTA: C’è un problema con SDXL nella versione corrente del webui automatic1111 (v1.6.0). Se usi un checkpoint raffinatore, il webui dimentica tutti i tuoi embedding finché non carichi un checkpoint diverso e poi ricarichi quello originale (o riavvii il webui). Ho segnalato il problema agli sviluppatori:
https://github.com/AUTOMATIC1111/stable-diffusion-webui/issues/13117
ed è stato confermato come bug.
- - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - -
***SINTESI***
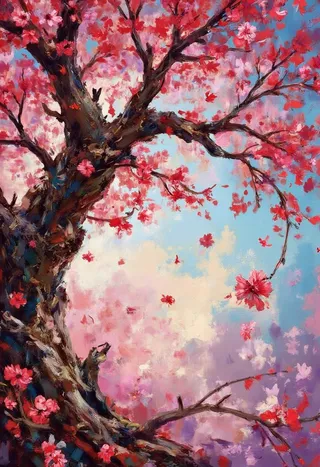
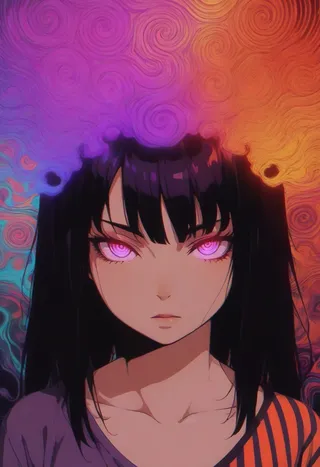
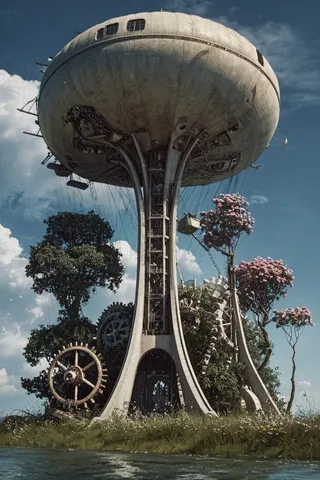
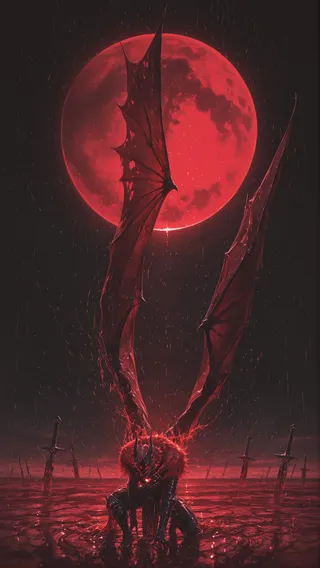
Questo embedding applicherà un'estetica surrealista/fantasy ispirata ai motivi vintage della carta marmorizzata. L’effetto varia da basso a estremo a seconda di quanto il tuo prompt sia già vicino a questa estetica.
L’addestramento per questo TI non includeva opere di artisti o tag.
Copia i dati di generazione da una delle immagini showcase e modificali a piacere, o inizia con un prompt come questo che dovrebbe dare un buon risultato con qualsiasi seed:
award-winning Art Nouveau xlmrblng15-1300, foto analogica realistica a colori di una sirena giapponese seduta su una roccia in mezzo a onde impetuose, molto dettagliata
checkpoint: crystalClearXL_ccxl.safetensors [0b76532e03]
sampler: DPM++ 2M Karras
passi: 40
CFG: 7
altezza=larghezza=1024
poi varia i termini a piacere. Cerca di mantenere tra 3 e 5 parole prima di “xlmrblng15-1300”.
I prompt più semplici da provare sono di questo tipo:
cybernetic nun, xlmrblng15-1300
fantasy winter landscape, xlmrblng15-1300
ma generalmente servono più parole per ottenere risultati interessanti.
Dopo molte sperimentazioni ho trovato che ottenevo i migliori risultati con prompt tra 30 e 45 token, senza prompt negativi.
Ho fornito alcune coppie di immagini prima/dopo nelle gallerie extra sotto.
xlmrblnh15 = senza questo TI
xlmrblng15 = con questo TI
Come vedrai, questo TI fa più che semplicemente aggiungere motivi di carta marmorizzata :-)
- - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - -
***MAGGIORI DETTAGLI & INFO SULL’ADDESTRAMENTO***
Questo è un embedding di inversione testuale, che modifica le tue generazioni di immagini aggiungendo motivi di carta marmorizzata o orientando verso questi motivi a seconda dei tuoi prompt. Per come funziona SDXL, l’effetto con prompt più lunghi/complessi sarà spesso strutturale piuttosto che semplicistico.
È il successore SDXL del mio MarblingTI per SD v1.5:
https://civitai.com/models/69768/marblingti
Per tutti i cambiamenti in SDXL ho avuto diversi falsi inizi (20+), ma penso che questo nuovo TI sia più utile del precedente... almeno per le cose surreali/illustrative che mi piace creare.
Passare da automatic1111 a kohya_ss per l’addestramento non è stato un processo semplice. Di più su questo sotto.
Il TI è formato da 8 vettori (cioè occupa 8 token del tuo prompt). È sovradimensionato per prompt brevi/semplici. È voluto - avevo fatto alcune versioni più sottili ma non erano utili per i prompt più lunghi/complessi che uso con SDXL. Da quello che capisco di stable diffusion, 4 vettori sarebbero stati sufficienti ma non riuscivo ad ottenere risultati coerenti con 4 vettori.
Il materiale di origine è costituito da scansioni/foto di carta marmorizzata vintage che sono state trasformate in diversi TI precursori, poi usati per creare immagini ibride, che sono diventate gli input per questo TI.
Per il prompt devi inserire 3-5 token all’inizio.
es.
portrait of a woman, xlmrblng15-1300
invece di
xlmrblng15-1300, portrait of a woman
Se usi un prompt corto/semplice probabilmente otterrai solo un motivo di carta marmorizzata vintage. Va bene ma è noioso. Inoltre, per prompt più corti il TI potrebbe aggiungere una lieve sfumatura verde alle immagini. Non sono sicuro del perché; le immagini di addestramento non hanno questa tonalità.
Peso/enfasi: da 0.81 fino a 1.33 è utilizzabile a seconda del prompt. Trovo che ottengo risultati più coerenti spostando il token TI piuttosto che usando il peso.
Tutta la generazione immagini per questo TI è stata fatta in automatic1111 webui v1.6.0. L’unica estensione non integrata che uso è Dynamic Prompts (installata tramite scheda Extensions). Non ho usato Hires.fix, in/outpainting, detailer o altri TI/LoRA ecc, così potete farvi un’idea dalle immagini showcase/galleria se vale la pena provare questo TI.
https://github.com/AUTOMATIC1111/stable-diffusion-webui
https://github.com/adieyal/sd-dynamic-prompts
Di solito uso CrystalClearXL:
https://civitai.com/models/122822?modelVersionId=133832
o SDXL FaeTastic
https://civitai.com/models/129681?modelVersionId=157988
checkpoint per generazione immagini SDXL, ma questo TI funziona con ogni checkpoint SDXL che ho provato.
Per come funziona il prompting, se vuoi vedere gli effetti con/senza questo TI cambia solo una lettera.
es.
CON: cybernetic nun, xlmrblng15-1300
SENZA: cybernetic nun, xlmrblnh15-1300
Puoi cambiare la parola trigger rinominando il file safetensors che hai scaricato. PROBLEMA: se cambi il trigger con una parola che SDXL “conosce” come marbling, otterrai risultati inaspettati. Anche se unisci parole come newmarbling, SDXL rileverà “new” e “marbling” e, ehm, farà cose con quelli invece che con il TI.
Il nome che ho usato serve per dirmi che è un TI SDXL, è marbling (mrblng), ed è l’iterazione 1300 del passo della versione 15.
Spesso uso un movimento artistico all’inizio dei miei prompt, per esempio Art Nouveau, così com’è o attenuato tra 0.3 e 0.5. Pagine di riferimento per i Movimenti Artistici:
https://en.wikipedia.org/wiki/List_of_art_movements
https://en.wikipedia.org/wiki/Periods_in_Western_art_history
Se non piace ai puristi del prompt, prova qualcosa come “award-winning illustrative”. Per me aggiungere un movimento artistico che mi piace significa non dover smanettare troppo sul resto del prompt per ottenere un effetto simile. I movimenti artistici che preferisco sono elencati in un file txt e messi nella cartella wildcards di Dynamic Prompts così da poter usare semplicemente __Art_Movements__ nei miei prompt.
Di norma non uso nomi di artisti salvo, occasionalmente, quelli postumi per un effetto molto particolare. es. René Lalique
https://it.wikipedia.org/wiki/Ren%C3%A9_Lalique
Ho iniziato a usare kohya_ss (v21.8.9) per l’addestramento TI dato che sembra che automatic1111 non aggiungerà l’addestramento SDXL al webui.
https://github.com/bmaltais/kohya_ss
Ci sono molte impostazioni/config in kohya_ss e ancora non capisco la metà :-( Comunque fornirò alcune info che potrebbero aiutare chi vuole addestrare stili SDXL Textual Inversion usando kohya_ss. Non ho provato un oggetto SDXL TI, e non riesco a far funzionare l’addestramento LoRA in kohya_ss (o non parte o si blocca a metà).
Posso solo descrivere le impostazioni che hanno funzionato sul mio PC, ma spero sia ancora utile per PC simili. Quindi...
Il PC che uso è:
Nvidia 3060/12GB (non versione Ti), MSI X570 mb, Ryzen 7-2700 (8c/16t), 64GB RAM sistema, vari SSD, Win10pro.
Ho creato questa struttura cartelle:
XLmrblng15
\--img
\--\--50_XLmrblng15 style
\--log
\--model
Immagini di addestramento:
Ho creato 45 immagini 1024x1024 e le ho messe nella cartella “50_XLmrblng15 style”. Poi creato un file .caption per ogni immagine. Esempio:
cliff with waterfall.png
cliff with waterfall.caption
I file caption sono solo file di testo quindi ho usato un editor semplice. Il contenuto di ogni .caption segue questo schema:
xlmrblng15, cliff with waterfall
È il nome del TI che sto creando, una virgola, uno spazio, e il nome descrittivo del file.
Non uso utility di captioning.
Per quel che segue, se un parametro non è menzionato significa che l’ho lasciato di default.
Nella tab principale “Textual Inversion” di kohya_ss:
Tab Source model
Model Quick Pick = custom
Salva modello addestrato come = safetensors
Nome o percorso modello preaddestrato = G:/stable-diffusion-webui-master/webui/models/Stable-diffusion/SDXL/sd_xl_base_1.0_0.9vae.safetensors
SDXL model = selezionato
Tab Folders
Cartella immagini = G:/KOHYA/TRAIN/XLmrblng15/img
Cartella output = G:/KOHYA/TRAIN/XLmrblng15/model
Cartella log = G:/KOHYA/TRAIN/XLmrblng15/log
Nome output modello = xlmrblng15
Tab Parameters (basic)
Stringa token = xlmrblng
Parola init = pattern
Vettori = 8
Template = caption
Precisione mista = bf16
Precisione salvataggio = bf16
Thread CPU per core = 1
Cache latenti = selezionato
Cache latenti su disco = selezionato
Scheduler LR = constant
Optimizer = AdamW8bit
Learning rate = 0.001
Massima risoluzione = 1024,1024
No half VAE = selezionato
Tab Parameters (advanced)
VAE = G:/KOHYA/sdxl_vae.safetensors
Salva ogni N passi = 100
Gradient checkpointing = selezionato
Memory efficient attention = selezionato
Max num workers per DataLoader = 4
Tab Parameters (samples)
Campiona ogni n passi = 100
Prompt campioni =
una fotografia analogica realistica di un magnifico vaso su un tavolo con bicchieri di vetro, molto dettagliata, intricata, xlmrblng15 --w 1024 --h 1024
xlmrblng15, una fotografia analogica realistica di una magnifica signora inglese che indossa un costume da bagno vittoriano, molto dettagliata, intricata, --w 1024 --h 1024
Con tutte queste impostazioni il tempo di addestramento si attesta intorno a 6s/it. Variabile perché uso ancora il PC per altre (semplici!) attività mentre kohya fa il suo lavoro. xlmrblng15-1300 è stato prodotto circa a 2h10min dall’avvio.
Gran parte del tempo di addestramento la RAM GPU è stata appena sotto i 12GB della mia 3060. Tuttavia, durante la generazione dei campioni e il salvataggio del TI ogni 100 passi venivano usati altri 7GB (cioè 19GB in totale). Quei 7GB extra vengono dalla “GPU Shared memory”, cioè la RAM di sistema principale. Dopo la generazione dei campioni l’uso di memoria tornava ai soli 12GB GPU.
Il rallentamento nell’uso della “Shared GPU memory” era circa di 10x. Maledizione :-(
Le immagini di esempio prodotte da kohya sono molto scarse rispetto a usare il modello base SDXL in automatic1111 webui. Ma le ho lasciate perché almeno potevo vedere se l’addestramento andava grossomodo nella direzione giusta.
Ovviamente il tuo dataset di addestramento è molto importante. Ho provato molte combinazioni di immagini generate e reali finché non ho ottenuto un set che ha prodotto il TI in questa pagina.
Per 45 immagini, con batch size 1 (default), il nome speciale della cartella “50_XLmrblng15 style” dice a kohya di processare le immagini 45 volte. 45 * 50 = 2250 passi totali. Dopo aver testato i vari TI salvati a 100, 200, 300 passi ecc. ho deciso che quello a 1300 passi era il migliore.
Nel tab Parameters-Basic c’è il campo “Init word”. Ho scoperto che l’addestramento è molto sensibile a cosa uso come init word. In questo caso ho usato “pattern” che è una parola a 1 token per SDXL. Teoricamente avrei dovuto usare una frase a 8 token (kohya lancia avviso se vettori ≠ init token). Per alcuni run ho usato più token e ottenuto TI molto interessanti, ma non quello che cercavo.
Usare “pattern” ha un effetto collaterale: a seconda del tuo prompt SDXL potresti ottenere molta ripetizione - come un motivo ripetuto nella carta da parati o nella carta regalo.
Usare “marblng” o “paper marbling” non ha funzionato: rispetto a SDv1.x, SDXL “conosce” molto di più la marmorizzazione. Provalo nei tuoi prompt! Chiedi marble/marbling/marbled e SDXL fa molto meglio di SDv1.x. Ogni volta che ho fatto un TI con init word marbling o termine concettualmente simile, quello che ottenevo era un TI che usava la marmorizzazione integrata di SDXL anziché l’addestramento dal mio dataset. :-(
Ho guardato la storia della carta marmorizzata e provato termini come “ebru”, la versione turca della carta marmorizzata. Neanche quello ha funzionato molto bene. Alla fine il termine molto ampio “pattern” mi ha dato quasi tutto ciò che volevo.
Kohya_ss ha l’opzione “style” nella tab Parameters-Basic. Ho avuto qualche buon risultato usando “style” per alcuni TI SDXL non pubblicati, ma per questo della carta marmorizzata i risultati non erano buoni.
Inversione testuale vs LoRA
Mi concentro sui TI perché (a) non riesco a completare un addestramento LoRA, e (b) voglio sfruttare il contenuto in SDXL invece di aggiungere altro sopra. Non sono contrario alle LoRA - anzi! Mi diverto molto con le LoRA di konyconi e altri. Ottengo risultati wow! :-)
Ma in questo momento mi sento più affine ai TI. Come la vedo io, i TI ti permettono di adattare i tuoi prompt verso aree di SDXL che le parole semplici non riescono a raggiungere, mentre le LoRA aggiungono cose nuove sopra SDXL che “mescoli” con il contenuto di SDXL tramite i prompt.
È molto semplice come descrizione ma non voglio entrare in discussioni sullo spazio campione completo di SDXL vs il suo spazio di probabilità, e cosa succede in un superset. Questo è un hobby per me, non un lavoro :-)
L’ultima cosa che menziono qui è che uso molto il sistema wildcard di Dynamic Prompts. I miei prompt tipici usando questo TI xlmrblng15-1300 assomigliano a questo:
(__Art_Movements__:0.5) xlmrblng15-1300, mature __Nationalities__ (__Character_MF__) riding a __BW_Animals__ in a white-tinted __Landscapes__, __Metal_Color__ filigree inlay
I prompt istanziati (cioè come appaiono dopo che Dynamic Prompts ha fatto il suo lavoro) tendono ad avere tra 30 e 45 token.
Quando trascino un’immagine generata nella scheda “PNG Info” di automatic1111 webui, un risultato tipico del prompt dinamico sopra è lungo 34 token:
(Surrealism:0.5) xlmrblng15-1300, mature Swedish (male vampire) riding a dalmation in a white-tinted mudflats with scarlet cranes, black filigree inlay
Perché mettere cose come nazionalità se SDXL ci fa poco caso in prompt lunghi? Perché SDXL è parziale e aggiungerà piccoli dettagli associati a nazionalità. Può essere il rosso dei capelli se menzioni Scottish, piramidi se menzioni Egyptian, o il Mt Fuji se menzioni Japanese. Funziona anche per altre cose; l’associazione di contesto sembra più forte in SDXL che in SDv1.x. Cercare di controllarlo è una seccatura :-(
Le risoluzioni che uso per SDXL sono solitamente 1024x1024, 960x1344 e 1344x960. Le risoluzioni suggerite che ho visto qua e là su internet consigliano di usare la base 1MP (megapixel) 1024x1024 ovviamente, e altre risoluzioni più vicine possibile a 1MP. Quindi se voglio una larghezza di 1344 devo usare altezza 768. Ho provato e la qualità percepita di 1344x768 era molto inferiore a 1024x1024 e 1344x960. Inoltre, 1344x960 scala esattamente per una stampa fotografica 7"x5". Quindi c'è quello :-)

Dettagli del Modello
Tipo di modello
Modello base
Versione del modello
Hash del modello
Parole addestrate
Creatore

Discussione
Per favore log in per lasciare un commento.
Collezione di Modelli - MarblingTIXL
Immagini di MarblingTIXL - v2.0
Immagini con fantasy




Immagini con stile




Immagini con surreale