MarblingTIXL - v2.0
精選圖片
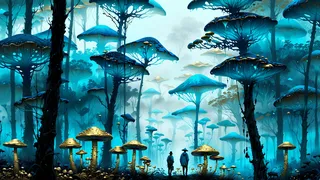
推薦提示詞
award-winning Art Nouveau xlmrblng15-1300, analog realistic colour photo of a Japanese mermaid sitting on a rock in the midst of crashing waves, very detailed
cybernetic nun, xlmrblng15-1300
fantasy winter landscape, xlmrblng15-1300
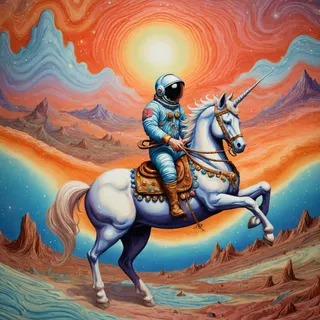
(__Art_Movements__:0.5) xlmrblng15-1300, mature __Nationalities__ (__Character_MF__) riding a __BW_Animals__ in a white-tinted __Landscapes__, __Metal_Color__ filigree inlay
very detailed, intricate
推薦參數
samplers
steps
cfg
resolution
vae
other models
推薦高解析度參數
upscaler
upscale
steps
denoising strength
提示
在 TI 標記前使用 3 至 5 個標記(例如 'portrait of a woman, xlmrblng15-1300')以獲得更佳效果。
最佳結果出現在提示詞長度介於 30 至 45 個標記且無負面提示詞時。
避免使用與 SDXL 已知概念重疊的 TI 觸發詞(如 'marbling'),會導致意外結果。
使用 Dynamic Prompts 的 wildcard 系統來豐富與創造多變提示。
使用 kohya_ss 訓練時需慎選初始化詞,建議用 'pattern' 取得最佳平衡且避免重複圖案。
TI 包含 8 個向量以加強效應,對短/簡提示過強。
生成時建議使用 DPM++ 2M Karras 取樣器,CFG 設為 7,步數 40。
使用接近 1MP 的解析度(1024x1024、960x1344、1344x960)能取得良好品質;1344x960 適合 7"×5" 打印尺寸。
版本亮點
此為使用現行 kohya_ss(本文撰寫時版本 v22.6.0)重新訓練,前版本使用設定已無法達成相同效果。有興趣者可參考附帶訓練數據與說明。訓練期間使用梯度累積為 4,故 500 步等效於無累積時的 2000 步。
2024年1月31日
v2.0 並非更優版本的 MarblingTIXL,只是不同而已。v1.0 仍然正常運作。
隨著 kohya 的改變,我發現我製作的 v1 版本的 TI 已經無法使用,或者說再也無法產生有用的效果。
感謝 @raken 提醒我這點。
我依然認為 SDXL 嵌入有巨大潛力,因此重新安裝了 kohya_ss(本文撰寫時版本為 v22.6.0),並試過各種參數設定,找到一組能製造與原始 MarblingTIXL 親近效果的組合。
若有人對 SDXL TI 有興趣(我知道至少有 2 位!),我已附上訓練數據與 kohya_ss 配置 JSON 文件。若想到有用的筆記,也會同步提供。
優點是此 TI 訓練速度較快……缺點是比舊 TI 穩定性稍差。或者我還沒完全摸索。前沿領域誰說得準呢?
若有任何問題、觀察、看法或經驗請於下方留言。目前網路上關於創建 TI 風格的實務資料相當稀缺……我看過、聽過不少相互矛盾的見解,不過這的確可行,我相信會有比我做得更好的 TI 作品出現。
跟 LoRA 比較?不算競爭——LoRA 是在檢查點上加東西,而 TI 是利用檢查點已有內容。如果我沒理解錯,TI 能將你帶至檢查點可能空間中的某些難以持續觸及的區域。換句話說,TI 與 LoRA 目的不同,且能結合使用,人人開心 :-)
有些技術論文介紹 TI 是什麼、如何訓練以及文本編碼器等,但我常看個幾頁就看不下去了 :-(
據我所知,kohya_ss 只訓練 SDXL 的第一個 TE(文本編碼器),即 SD v1.x 的那個,該版本理應能在 auto1111 SDXL 生成中用,但實際卻不能。(有人說 SD v1.x TI 在 Comfy 可用,但體驗不一。)第二個 TE(SD v2.x)似乎沒有在 kohya_ss 中訓練,或者它是 TE1 的複本?
我也嘗試過 OneTrainer(有雙 TE 選項),但跑過幾次都沒成功,所以目前堅持用 kohya_ss。
參考用機器是性能良好的 RTX-3060 12GB PC。當前 kohya_ss 運行時幾乎用完 12GB(如果還生成樣本,則再額外多 6GB),因此資源消耗比 LoRA 大。原以為 TI 需要的資源會少或相同,有點意外。或許暫時沒需求特別優化 TI?
此 TI 訓練基於:
sd_xl_base_1.0_0.9vae.safetensors
展示圖使用:
crystalClearXL_ccxl.safetensors [0b76532e03]
意即以 vanilla base 訓練的 TI 可適用於其他檢查點。
圖片於 a1111 v1.7.0 生成,使用了 Hires.fix,未用其他調整器。
下方附有無 TI/有 TI 對照圖,標籤“xlmrblnh36-500”為無 TI,“xlmrblng36-500”為有 TI。這樣標示方便盡量讓兩個提示詞保持相似。
有興趣者可下載訓練數據壓縮包,其中包含每 25 步(*4 梯度累積 = 100 標準步)儲存的所有 TI。
--------------------------
附帶:automatic1111 webui(v1.6.0)現行版對 SDXL 有個問題。若使用 refiner 檢查點,webui 會忘記所有嵌入,需切換其他檢查點後再重載原檢查點(或重啟 webui)才能恢復。已向開發者反映:
https://github.com/AUTOMATIC1111/stable-diffusion-webui/issues/13117
已確定為 BUG。
--------------------------
***摘要***
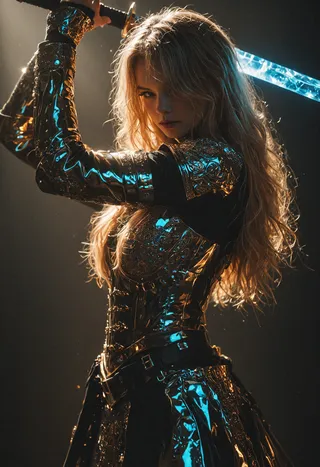
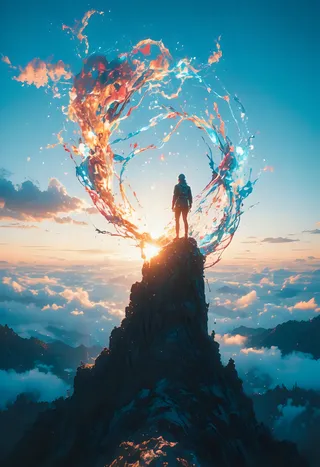
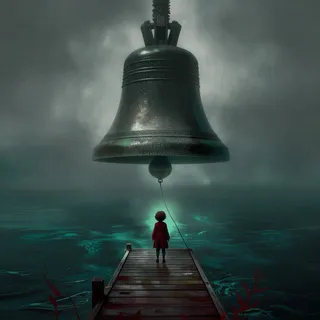
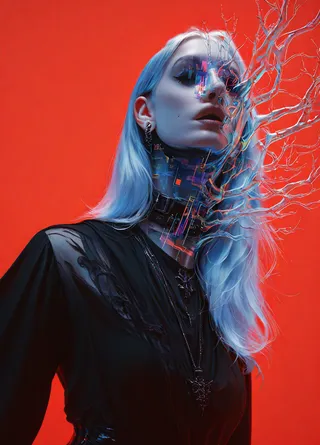
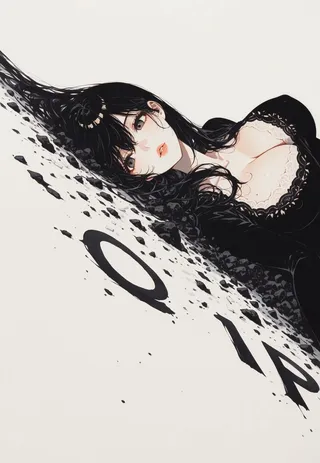
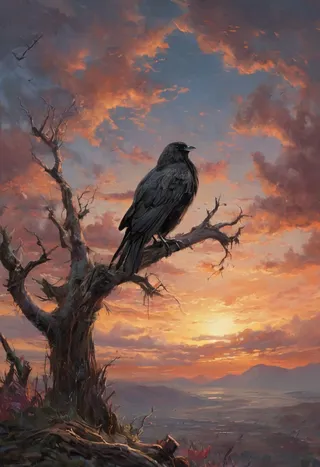
此嵌入賦予影像一種受復古大理石紙紋樣啟發的超現實/奇幻美學。效果會因提示詞與該美學接近程度而從輕微到極端不等。
訓練過程未包含任何藝術家作品或標籤。
可複製展示圖的生成設定調整使用,或嘗試以下提示詞搭配任意種子,亦能產生不錯結果:
award-winning Art Nouveau xlmrblng15-1300, analog realistic colour photo of a Japanese mermaid sitting on a rock in the midst of crashing waves, very detailed
檢查點:crystalClearXL_ccxl.safetensors [0b76532e03]
取樣器:DPM++ 2M Karras
步數:40
CFG:7
寬高:1024×1024
並可自由調整詞彙。請盡量保持“xlmrblng15-1300”前詞語約 3 到 5 個。
可嘗試最簡單的提示詞,如:
cybernetic nun, xlmrblng15-1300
fantasy winter landscape, xlmrblng15-1300
不過通常需要更多文字才能得到有趣結果。
經過多次實驗,最佳結果於提示詞長度 30 至 45 標記間,且不含負面提示詞。
下方額外圖庫展示多組前後對比圖。
xlmrblnh15 = 無此 TI
xlmrblng15 = 有此 TI
你會看到此 TI 不只是簡單添加大理石紋理 :-)
--------------------------
***詳細說明與訓練資訊***
此為文本反演(TI)嵌入,依據提示詞為生成影像添加或調整成大理石紙紋理。因 SDXL 系統特性,長且複雜提示詞往往具有 結構性效果,而非簡單重疊紋路。
它是我對 SD v1.5 的 MarblingTI 的 SDXL 繼任:
https://civitai.com/models/69768/marblingti
由於 SDXL 變動大,嘗試很多次(20 多次失敗起步),我認為此新版 TI 比舊版更有用……至少對我喜愛的超現實/插畫風作品。
切換訓練工具自 automatic1111 至 kohya_ss 並不容易,後面有更多說明。
此 TI 佔用 8 個向量(即提示詞佔 8 個標記)。對短/簡單提示詞來說過強,屬預設設計。我有試過較細膩版,但對 SDXL 長複雜提示詞沒用。依我理解,Stable Diffusion 正常應該 4 向量足矣,但使用 4 向量無法穩定產出結果。
源素材為掃描/拍攝的復古大理石紙,先產生數個前驅 TI,再用於混合產圖,成為此 TI 訓練輸入。
提示詞使用時,前面需放 3 到 5 個標記。
例如:
portrait of a woman, xlmrblng15-1300
而非
xlmrblng15-1300, portrait of a woman
若用短而簡單的提示詞,產出多為復古大理石紋,雖精美卻單調。且短提示可能使影像略帶綠色偏差,原因不明,訓練圖並無此色調。
權重/強調度可在 0.81 至 1.33 之間調整,視提示詞而定。我發現透過移動 TI 標記位置而非改變權重,更能穩定效果。
所有該 TI 生成圖皆用 automatic1111 webui v1.6.0,唯一外掛是 Dynamic Prompts(於擴展標籤安裝)。未使用 Hires.fix、外擴繪製、細節增強器或其他 TI、LoRA,方便大家從展示圖判斷是否值得使用此 TI。
https://github.com/AUTOMATIC1111/stable-diffusion-webui
https://github.com/adieyal/sd-dynamic-prompts
我常用 CrystalClearXL:
https://civitai.com/models/122822?modelVersionId=133832
或 SDXL FaeTastic
https://civitai.com/models/129681?modelVersionId=157988
作為 SDXL 圖像生成檢查點,但此 TI 對試過的所有 SDXL 檢查點皆兼容。
因提示詞運作模式,若想比對有無此 TI 效果,僅需改變標記一個字母:
有 TI:cybernetic nun, xlmrblng15-1300
無 TI:cybernetic nun, xlmrblnh15-1300
可透過重新命名 safetensors 檔案變更觸發詞。問題是若更換至 SDXL“認識”的詞(如 marbling),會產生意料外效果。即使組合新詞如 newmarbling,SDXL 仍會分辨“new”與“marbling”並各自作用而非啟動 TI。
此名稱用以提示為 SDXL TI,已大理石紋理(mrblng),版本第 15 次訓練 1300 步。
我常在提示開頭放藝術流派,如 Art Nouveau,原樣或降低權重至 0.3 至 0.5。可參考藝術流派列表:
https://en.wikipedia.org/wiki/List_of_art_movements
https://en.wikipedia.org/wiki/Periods_in_Western_art_history
若不合嚴謹派,可用類似“award-winning illustrative”。對我來說,加上喜愛的藝術流派,可省去較多提示調整以達類似效果。我將喜愛流派列於 txt,放入 Dynamic Prompts 的 wildcards 資料夾,方便直接用 __Art_Movements__。
原則上不使用藝術家名,除非是追求特定效果的逝世藝術家,例如 René Lalique:
https://en.wikipedia.org/wiki/Ren%C3%A9_Lalique
由於 automatic1111 可能不會加入 SDXL 訓練,我開始用 kohya_ss (v21.8.9) 來訓練 TI:
https://github.com/bmaltais/kohya_ss
kohya_ss 設置繁多,我仍不了解一半 :( 但以下分享部分設定,或對想用 kohya_ss 訓練 SDXL TI 的朋友有用。我未嘗試過 SDXL TI 物件,kohya_ss 無法成功訓練 LoRA(開始訓練失敗或中途崩潰)。
以下均為我個人 PC 實測有效設定,希望也適用於類似配置。
我用的 PC 配置:
Nvidia 3060/12GB(非 Ti),MSI X570 主板,Ryzen 7-2700 (8核16線),64GB RAM,多個 SSD,Win10pro。
建立資料夾結構:
XLmrblng15
\--img
\--\--50_XLmrblng15 style
\--log
\--model
訓練圖:
準備了 45 張 1024x1024 圖放於“50_XLmrblng15 style”資料夾,為每張生成一個 .caption 檔。例如:
cliff with waterfall.png
cliff with waterfall.caption
.caption 文件為純文字,用簡單編輯器撰寫,格式一致:
xlmrblng15, cliff with waterfall
即 TI 名稱、逗號、空格、描述標題檔名。
我未使用自動標註工具。
以下未提及參數皆設為預設。
kohya_ss 主頁籤“Textual Inversion”:
來源模型:
Model Quick Pick = custom
儲存訓練模型格式 = safetensors
預訓練模型路徑 = G:/stable-diffusion-webui-master/webui/models/Stable-diffusion/SDXL/sd_xl_base_1.0_0.9vae.safetensors
SDXL 模型 = 選取
資料夾頁籤:
圖片資料夾 = G:/KOHYA/TRAIN/XLmrblng15/img
輸出資料夾 = G:/KOHYA/TRAIN/XLmrblng15/model
記錄資料夾 = G:/KOHYA/TRAIN/XLmrblng15/log
模型輸出名稱 = xlmrblng15
參數(基礎):
標記字串 = xlmrblng
初始化詞 = pattern
向量數量 = 8
模板 = caption
混合精度 = bf16
保存精度 = bf16
每核心 CPU 執行緒數 = 1
緩存潛變 = 選取
緩存潛變至磁碟 = 選取
學習率調度器 = constant
優化器 = AdamW8bit
學習率 = 0.001
最大解析度 = 1024,1024
無半 VAE = 選取
參數(進階):
VAE = G:/KOHYA/sdxl_vae.safetensors
每 N 步保存 = 100
梯度檢查點 = 選取
記憶體高效關注 = 選取
DataLoader 最大工作者數 = 4
參數(樣本):
每 n 步取樣一次 = 100
樣本提示詞 =
an analog realistic photograph of a magnificent jug on a table with glass tumblers, very detailed, intricate, xlmrblng15 --w 1024 --h 1024
xlmrblng15, an analog realistic photograph of a magnificent English lady wearing a Victorian bathing dress, very detailed, intricate, --w 1024 --h 1024
上述設定下,訓練時間約 6 秒/次迭代。由於我同時使用 PC 做其他簡單任務,時間略變動。xlmrblng15-1300 版本約於運行 2 小時 10 分達成。
訓練大半期間,GPU VRAM 使用接近 3060 的 12GB。生成樣本及每 100 步保存 TI 時另用 7GB(共 19GB),該 7GB 為“共享 GPU 記憶體”,即主系統 RAM。生成完成後回復僅用 GPU VRAM 12GB。
使用“共享 GPU 記憶體”時,整體速度降約 10 倍,真是折磨 :(
kohya 生成的樣本圖質量遠不如 auto1111 webui 使用基礎 SDXL 模型。但我保留它們以確保訓練方向大致正確。
訓練資料集非常關鍵,我嘗試許多現成與真實圖像組合,直到組成此頁所示 TI。
45 張圖,批次大小 1(預設),資料夾名“50_XLmrblng15 style”告知 kohya 處理圖像 45 次。45 × 50 = 共 2250 步。透過測試不同儲存版本(100、200、300 步等),我覺得 1300 步版本最佳。
在參數基礎頁籤有“Init word”欄位,訓練對初始詞敏感。此案我用“pattern”,在 SDXL 看來屬 1 標記詞。理論上應該用 8 標記詞(kohya 控制台會警告向量數與init詞不符)。我也試過多標記詞版本,得到有趣 TI,但非目標效果。
用“pattern”的缺點是,根據提示詞,可能產生大量重複,如牆紙或包裝紙上的重複圖案。
使用“marblng”或“paper marbling”失效,因 SDXL 比 SDv1.x 對大理石紋識別更深入。試過以提示詞要求大理石紋理,SDXL 表現遠勝 SDv1.x。用“marbling”或類似詞作初始詞,TI 反倒觸發了 SDXL 內建大理石效果而非訓練資料學習效果 :-(
研究過大理石紙歷史,嘗試過如土耳其“ebru”等詞,效果仍不佳。最後選擇寬泛詞“pattern”,較接近期望。
kohya_ss 進階版有“style”模板,我對私用 SDXL TI 有用過,效果不錯,但對此大理石紙 TI 效果不佳。
文本反演(TI) vs. LoRA:
我專注於 TI 因為(a)無法讓 LoRA 完成訓練,(b)想利用 SDXL 內含內容而非額外覆蓋。並非反對 LoRA,反而玩得很開心,特別是 konyconi 等人的 LoRA,成果驚人!
但我目前較偏好 TI。我看法是 TI 幫你調整提示詞,進入 SDXL 中非簡單詞彙可逹區域,LoRA 則是在 SDXL 內容上疊加新內容,透過提示詞融合。
這說得簡單粗暴,不想牽涉到 SDXL 樣本空間與機率空間及超集等複雜理論。對我來說,這只是興趣,非工作 :-)
最後一點是我重度使用 Dynamic Prompts 的 wildcards 系統。我的典型提示詞以此 TI xlmrblng15-1300 為例:
(__Art_Movements__:0.5) xlmrblng15-1300, mature __Nationalities__ (__Character_MF__) riding a __BW_Animals__ in a white-tinted __Landscapes__, __Metal_Color__ filigree inlay
經過 Dynamic Prompts 處理後的提示詞通常 30 至 45 個標記。
把生成圖拖曳到 auto1111 webui 的「PNG Info」頁籤,提示詞典型長度為 34 標記:
(Surrealism:0.5) xlmrblng15-1300, mature Swedish (male vampire) riding a dalmation in a white-tinted mudflats with scarlet cranes, black filigree inlay
為何放國籍?SDXL 對這些在長提示時忽略很少。因為 SDXL 有偏好,會添加與國籍關聯的附加元素,如提到 Scottish 會加紅髮,Egyptian 會加金字塔,Japanese 會加富士山。其他類似情況也會如此;SDXL 的上下文關聯遠勝 SDv1.x,難以完全控制 :-(
我用的 SDXL 主要解析度是 1024×1024、960×1344 與 1344×960。網路上建議使用基礎的 1MP(1024×1024)及接近 1MP 的其他解析度。若選 1344 寬度,理應用 768 高度。我試過,1344×768 視覺質量不及 1024×1024 和 1344×960。1344×960 則完全符合 7" × 5" 照片紙尺寸,挺適合的 :-)


模型合集 - MarblingTIXL
MarblingTIXL - v2.0 的圖片
奇幻 圖片


風格 圖片




超現實 圖片