一鏡三十秒
Seedance 2.5 一鏡生成的三十秒
2.0 系列上限的兩倍,最多 30 個參考輸入,音訊與畫面一同生成而非事後加上。
Seedance 2.5,以及你會拿來比較的五個模型
我們把同一條 prompt 跑過全部六個。每一個都在上面那個輸入框裡。
“A chef in a busy kitchen looks straight at camera and says, "the secret is butter."”
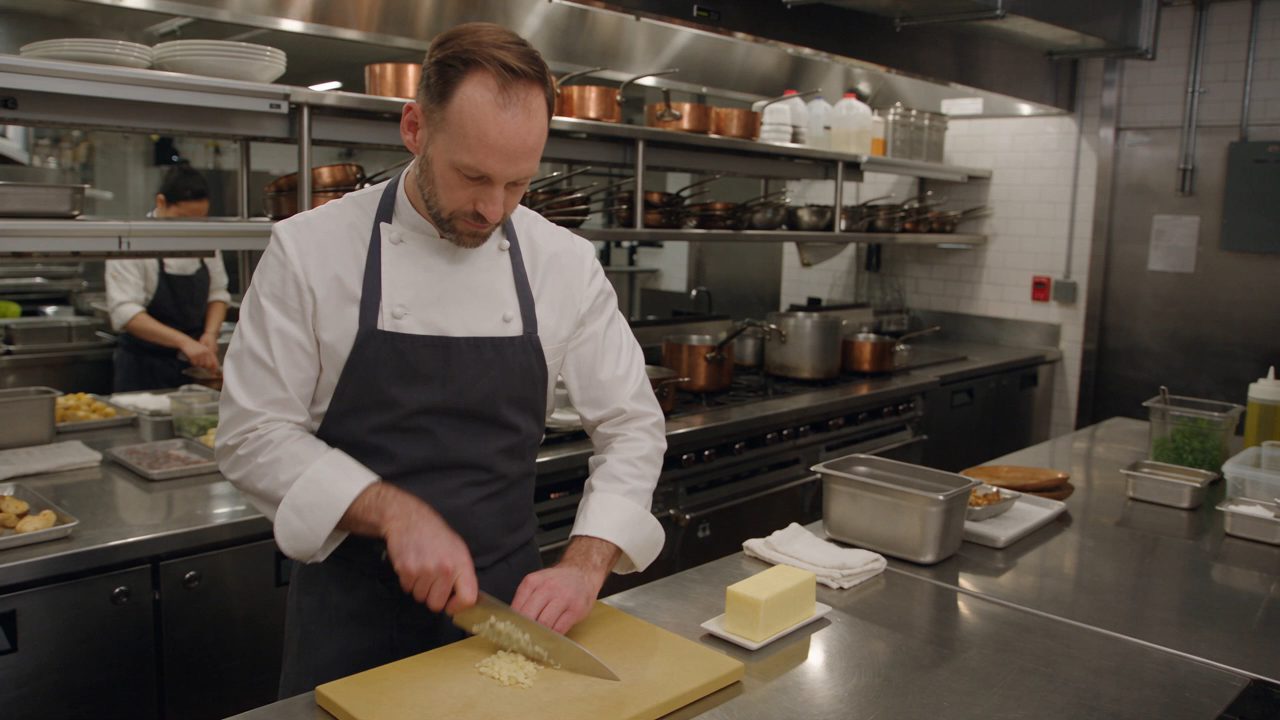 本頁模型
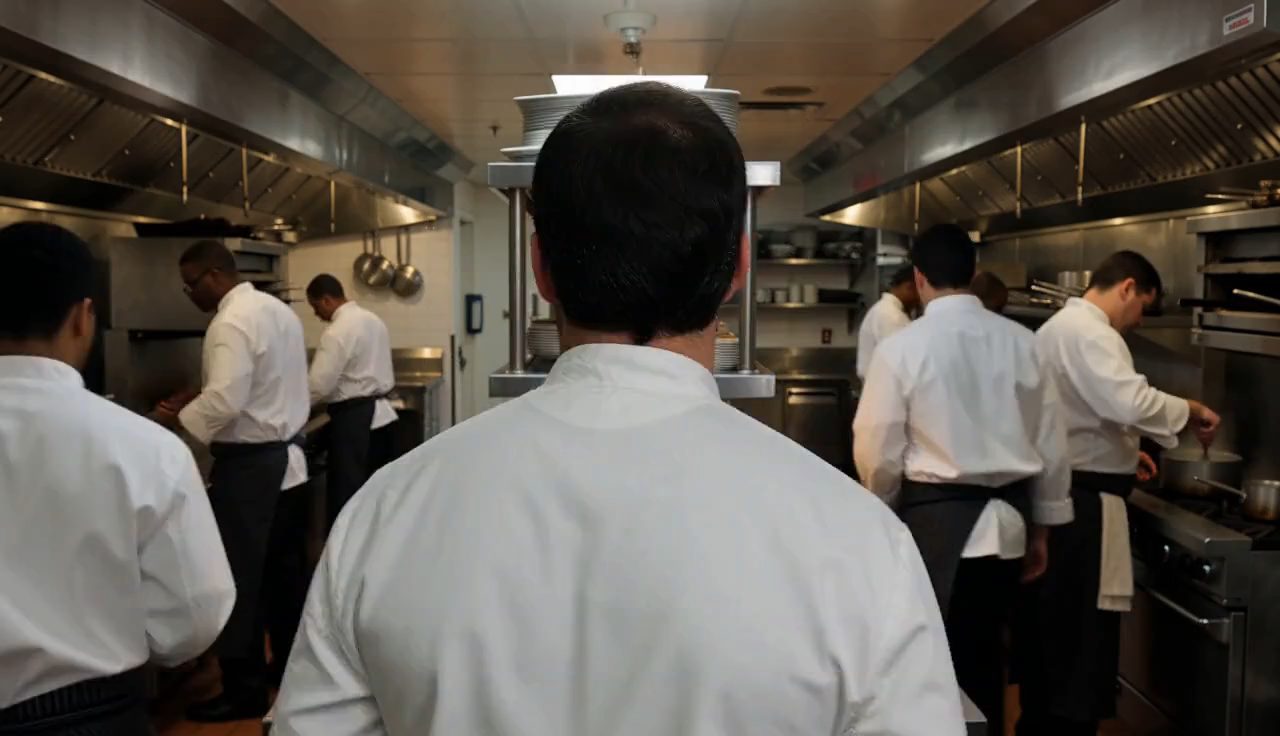
MiniMax H3
口型與音軌對不對得上。
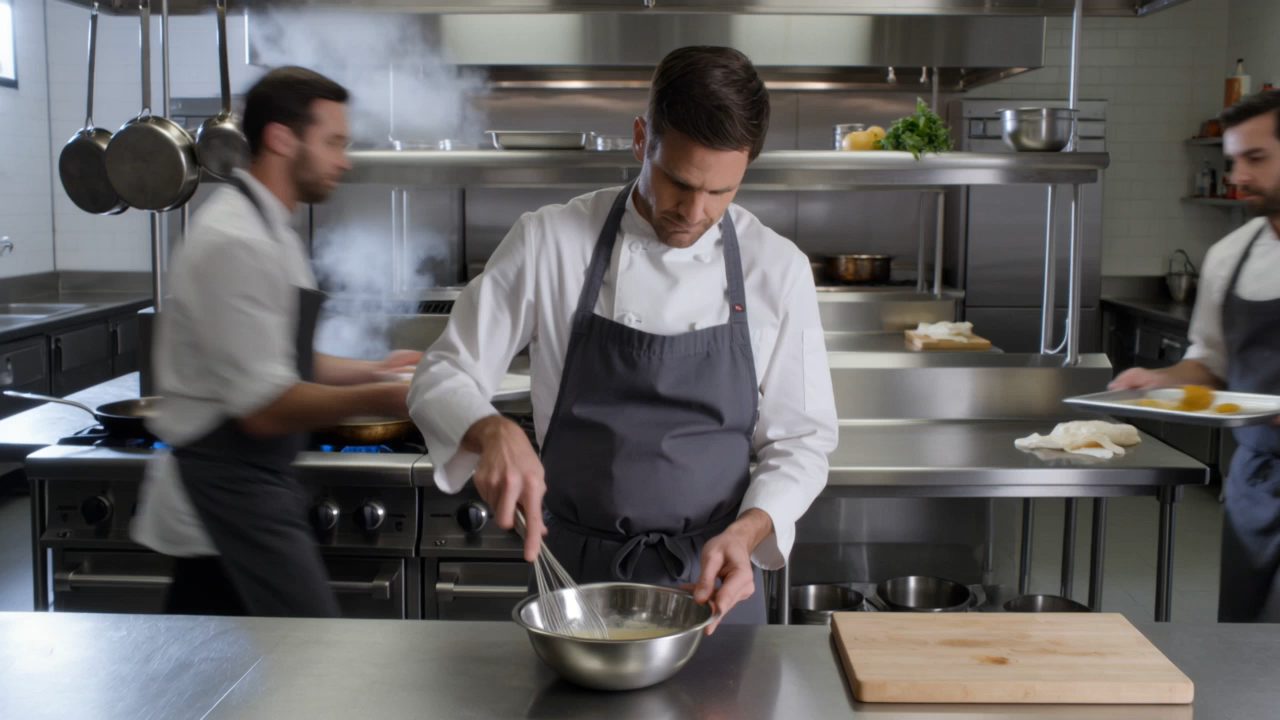
Kling 3 Omni
鏡頭穩下來時的皮膚與髮絲細節。
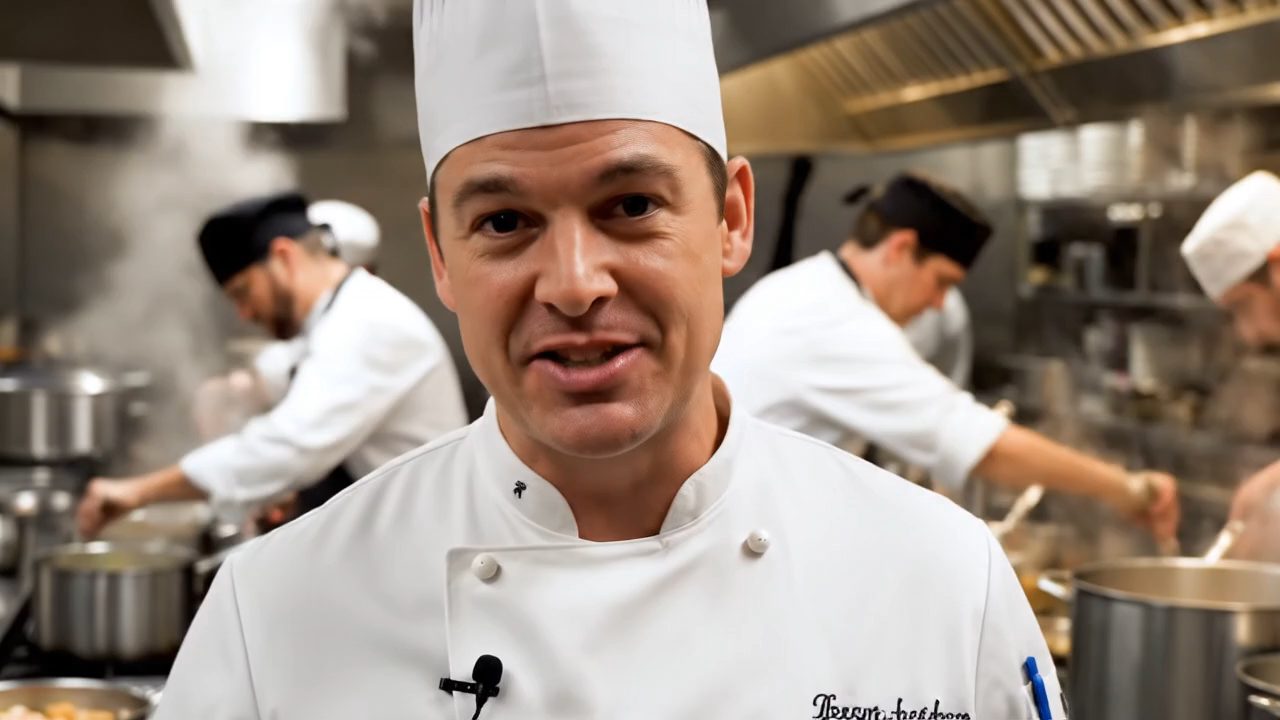
Veo 3.1
視線有沒有一直看著鏡頭。
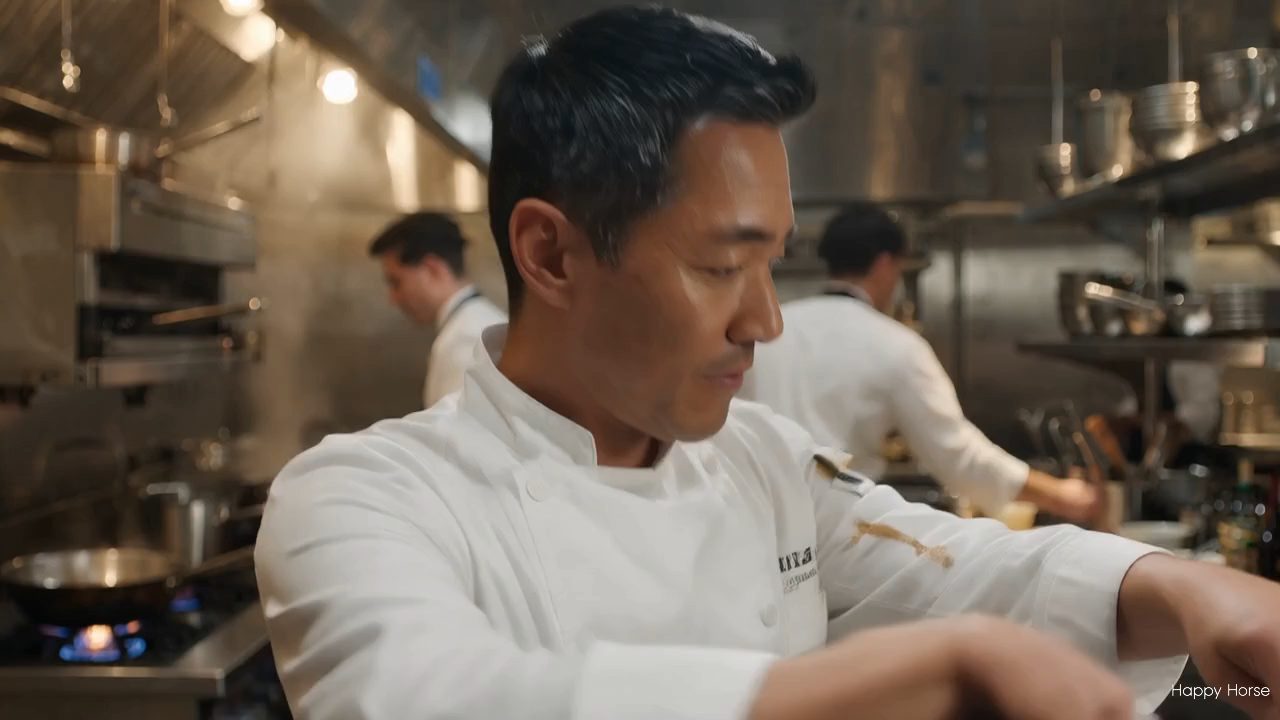
Happy Horse 1.0
轉頭時臉部保持得如何。
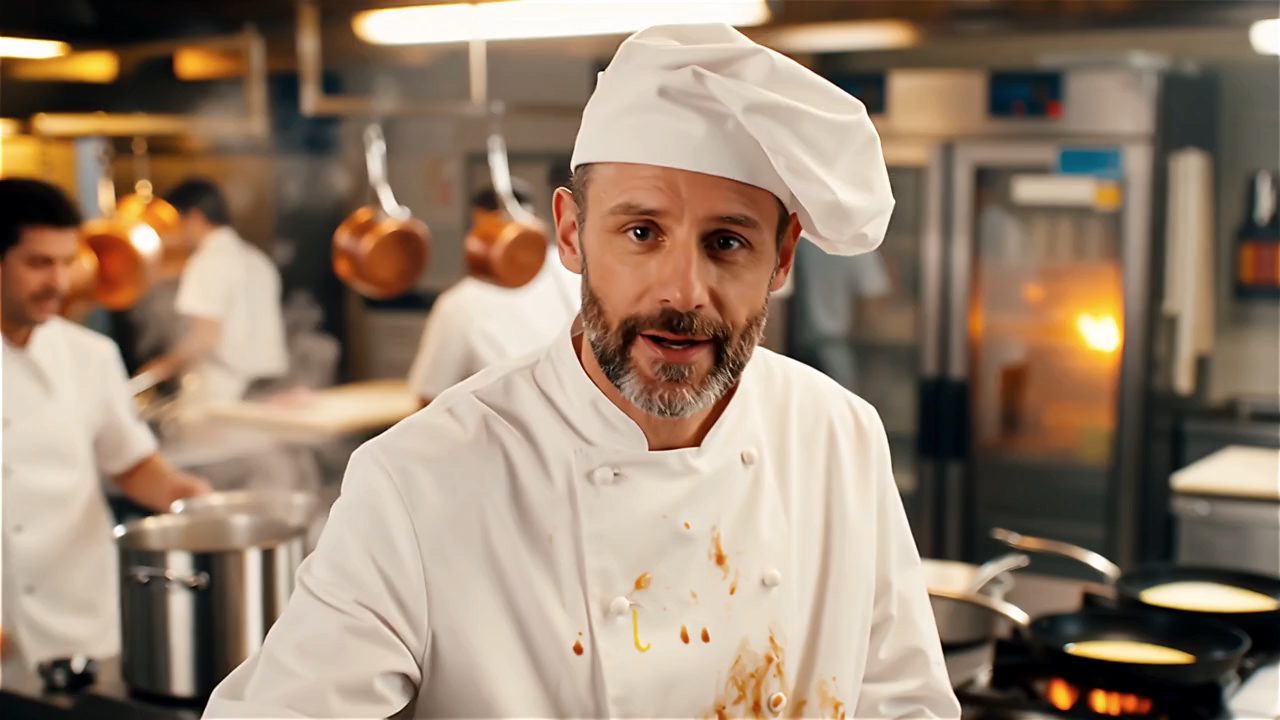
Wan 2.5
近距離下皮膚與布料的質感。
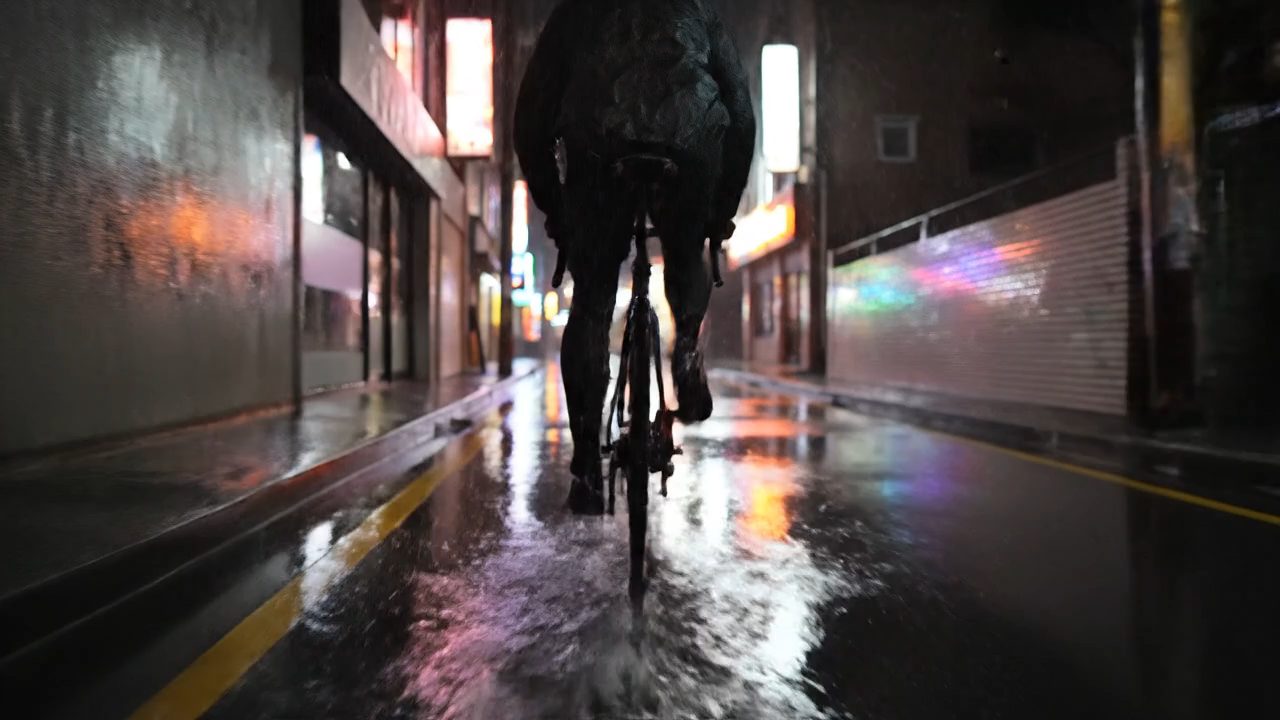
“Handheld shot following a cyclist through a rainy neon alley, water spraying from the tyres.”
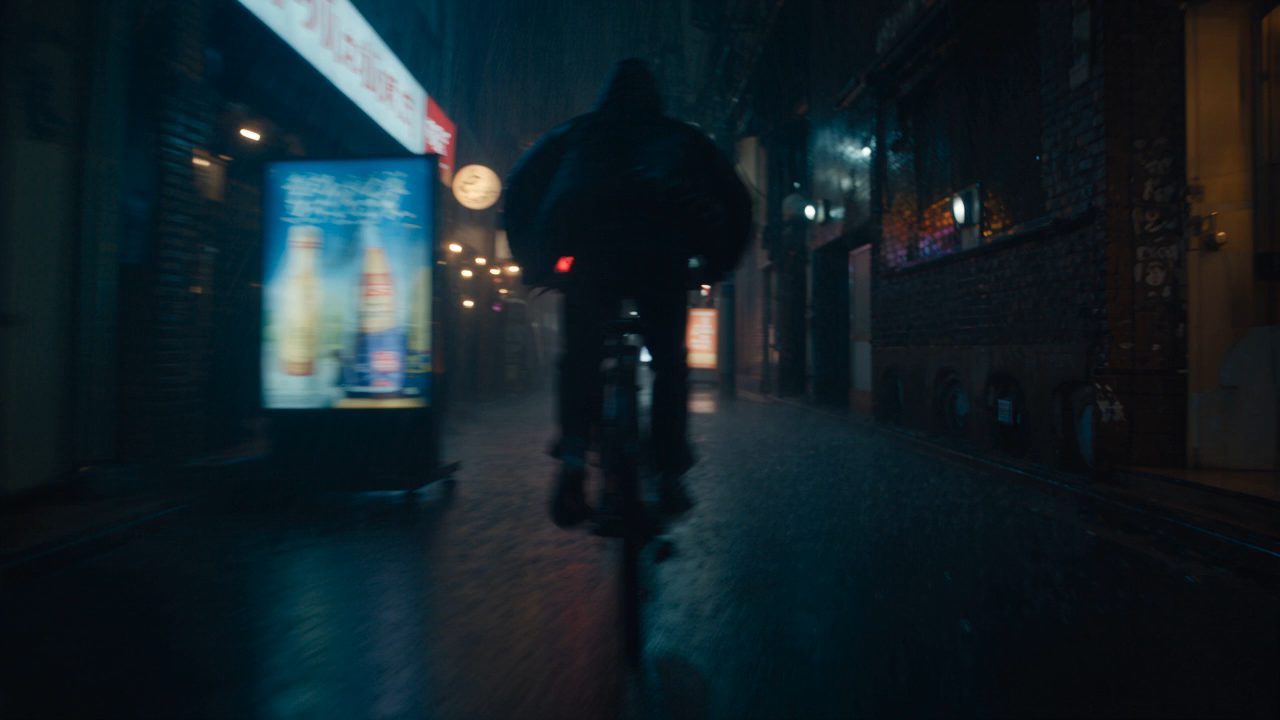 本頁模型
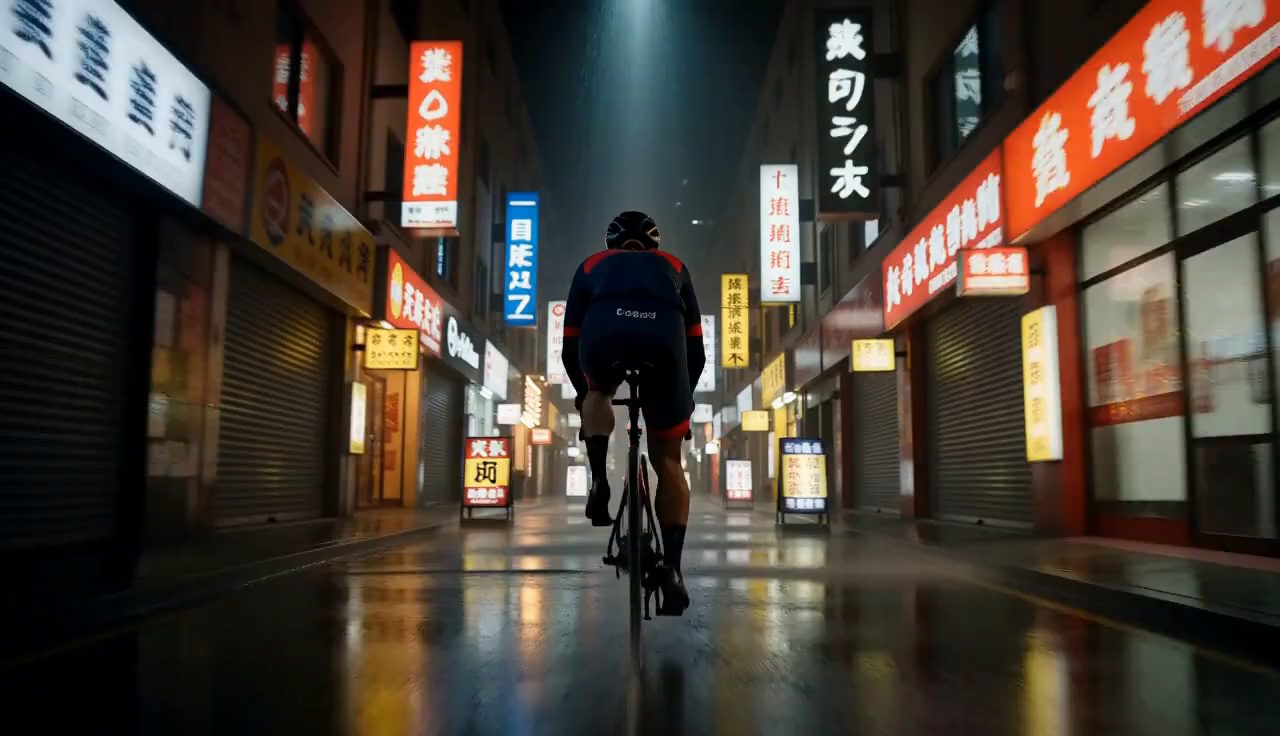
MiniMax H3
橫搖最快那段的動態模糊。
Kling 3 Omni
轉向那一刻的四肢。
Veo 3.1
追著光源走的反射。
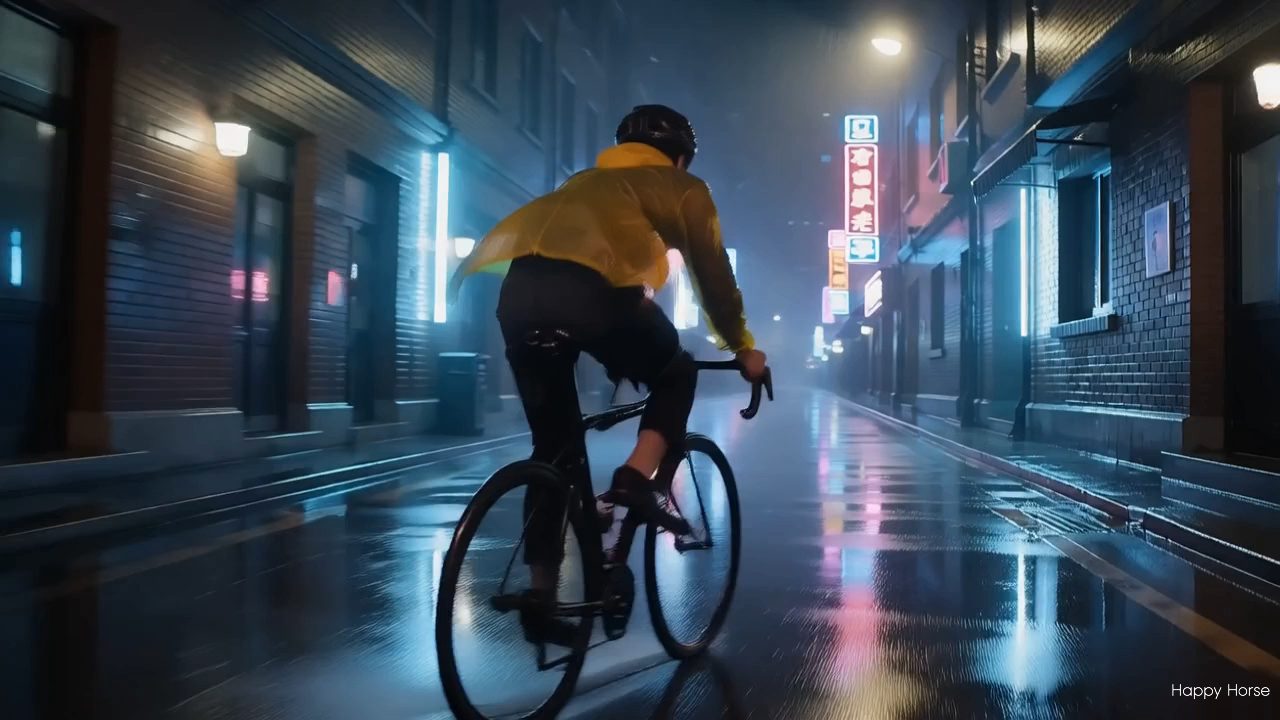
Happy Horse 1.0
鏡頭移動時畫面還清不清晰。
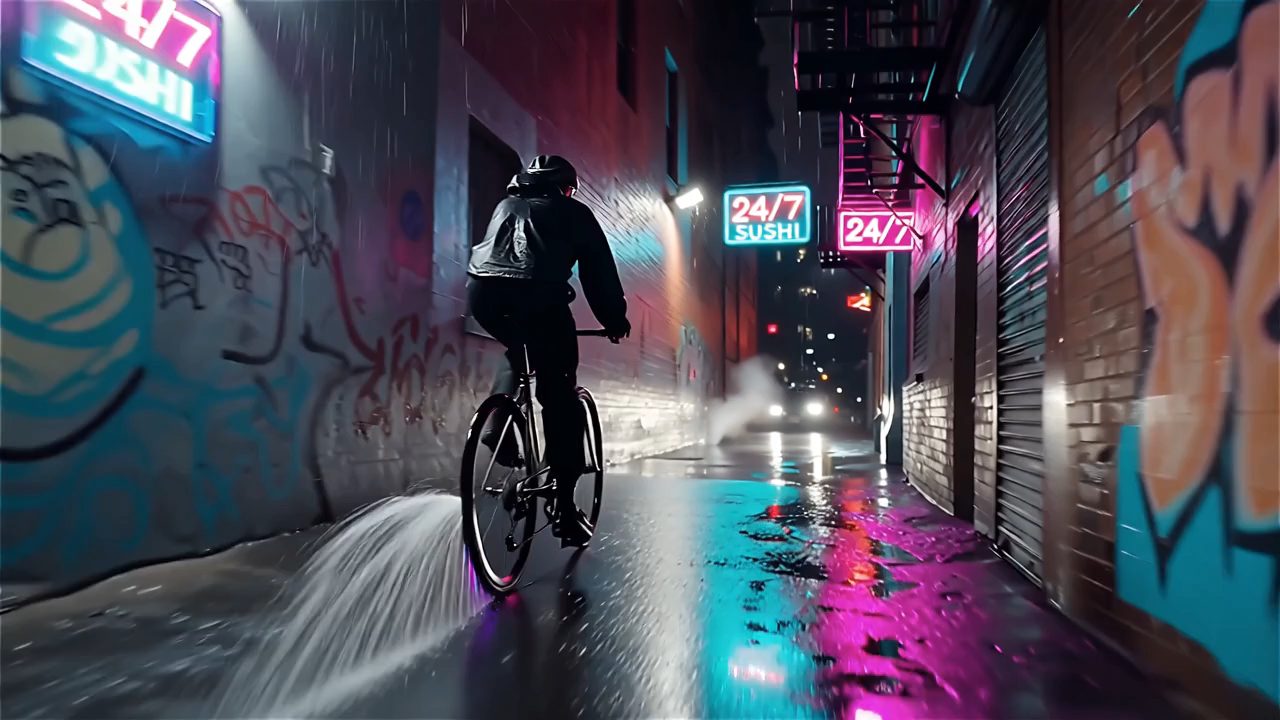
Wan 2.5
背景撐不撐得住。
“A neon sign reading OPEN LATE flickers above a diner door at night.”
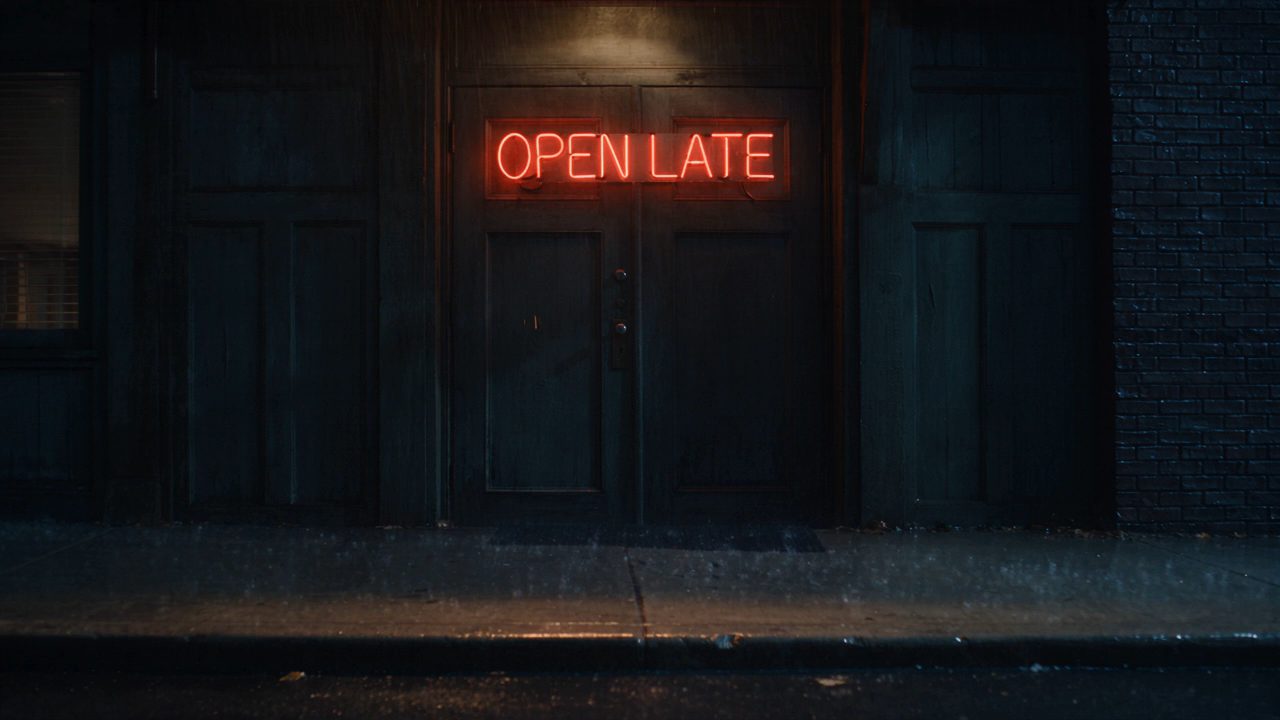 本頁模型
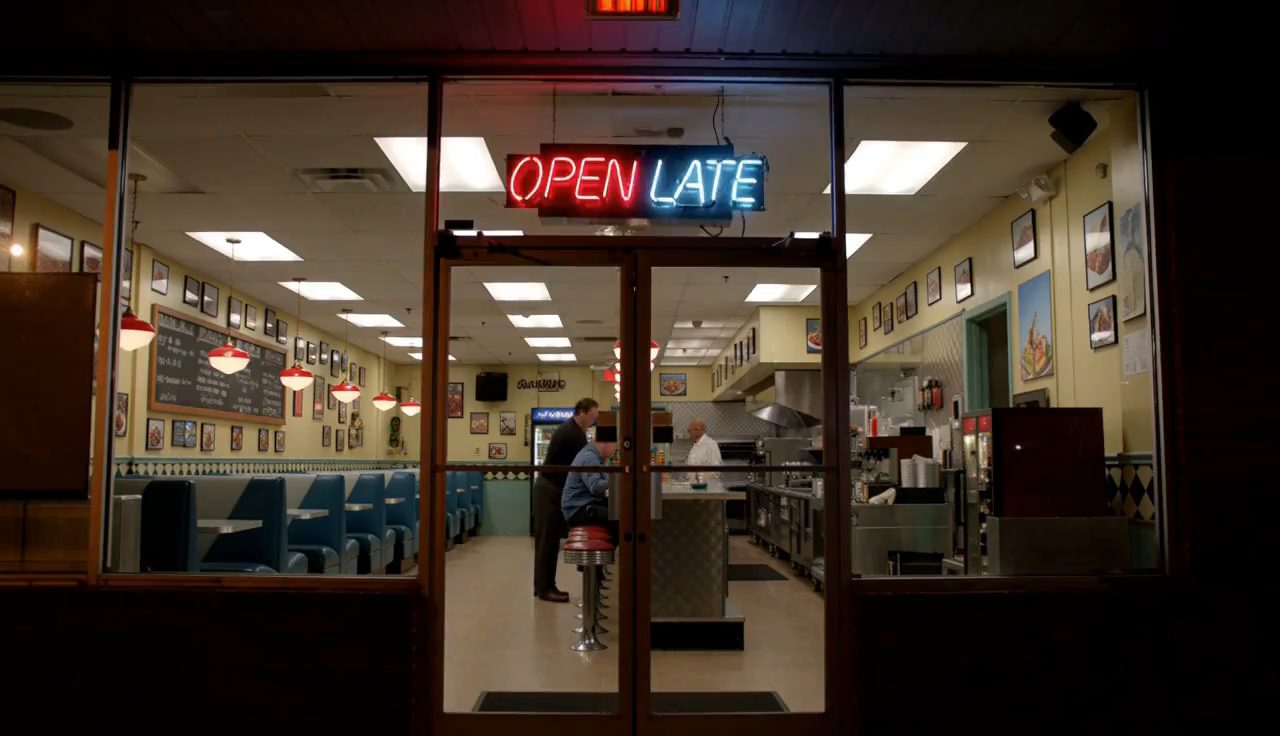
MiniMax H3
招牌對焦後的字形。
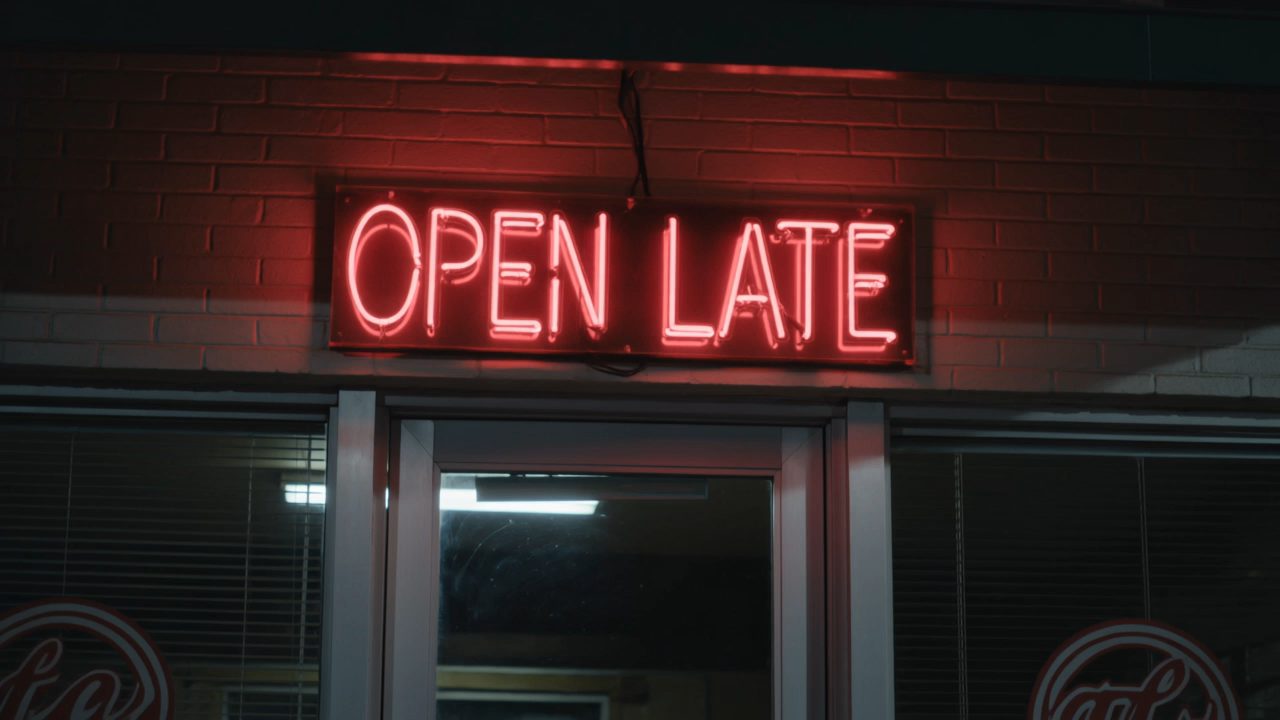
Kling 3 Omni
拼字對不對,而不只是字形像不像。
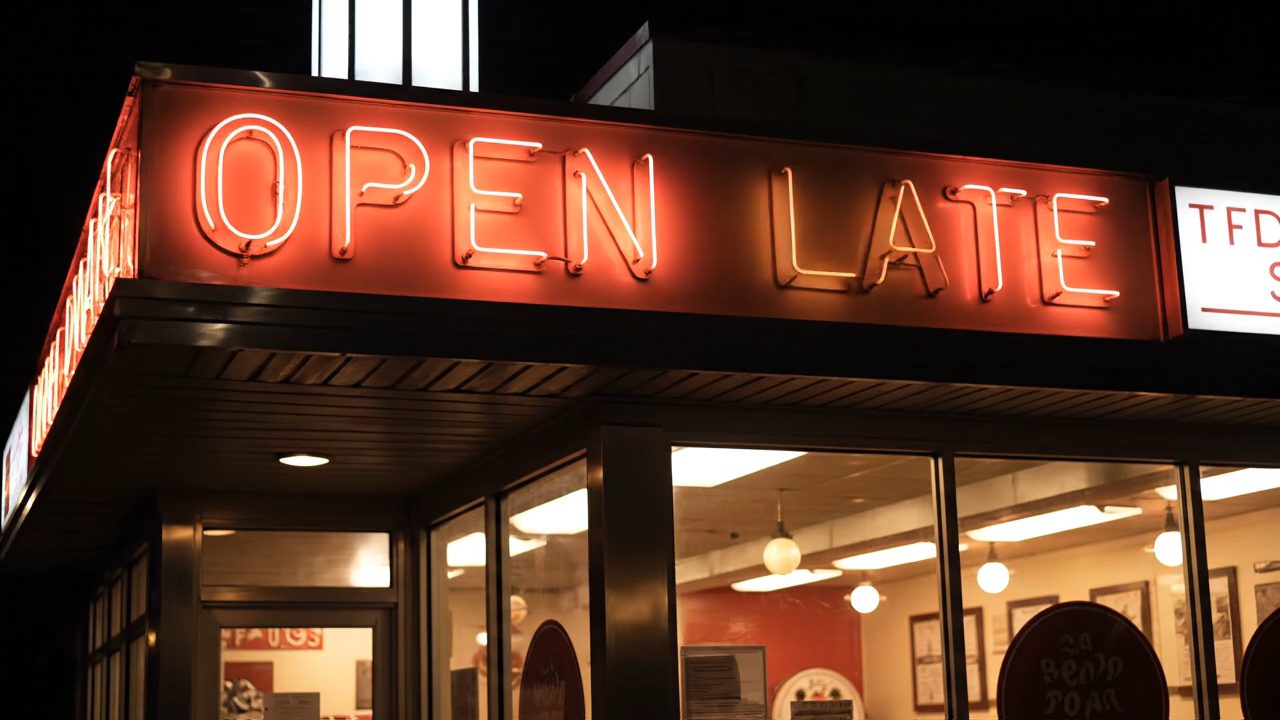
Veo 3.1
霓虹光下的字距。
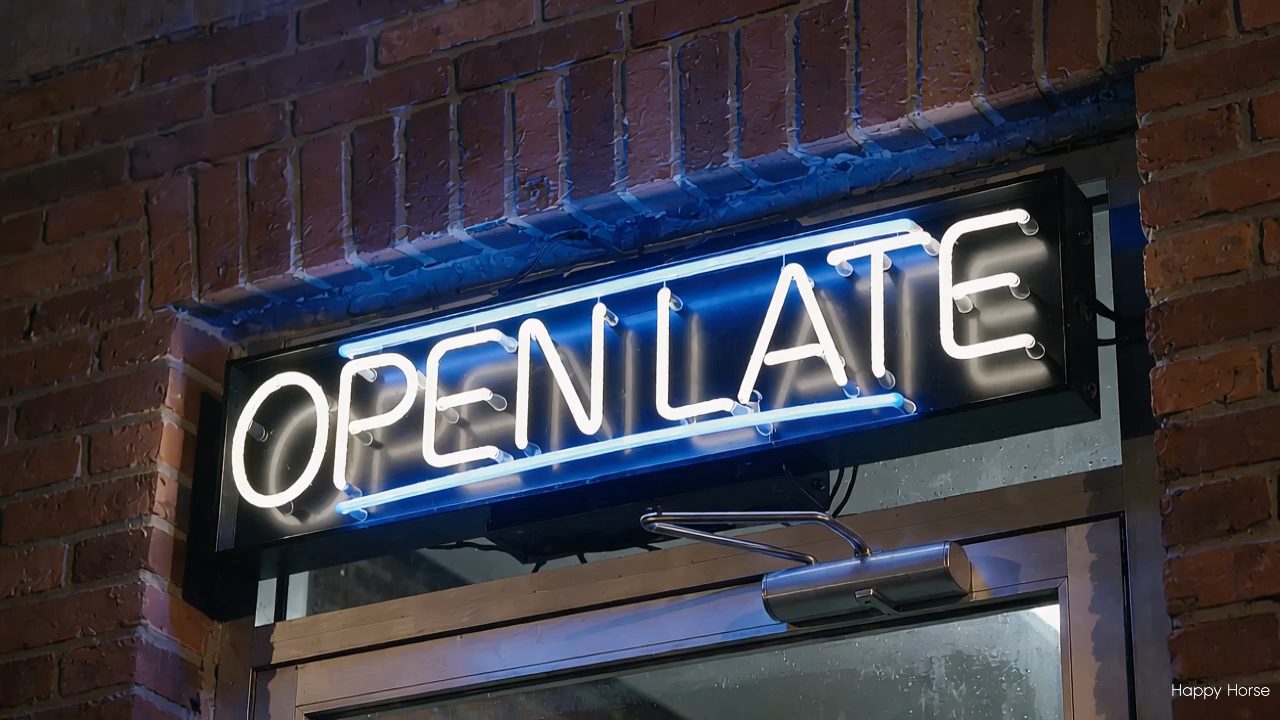
Happy Horse 1.0
招牌對焦後的小字。
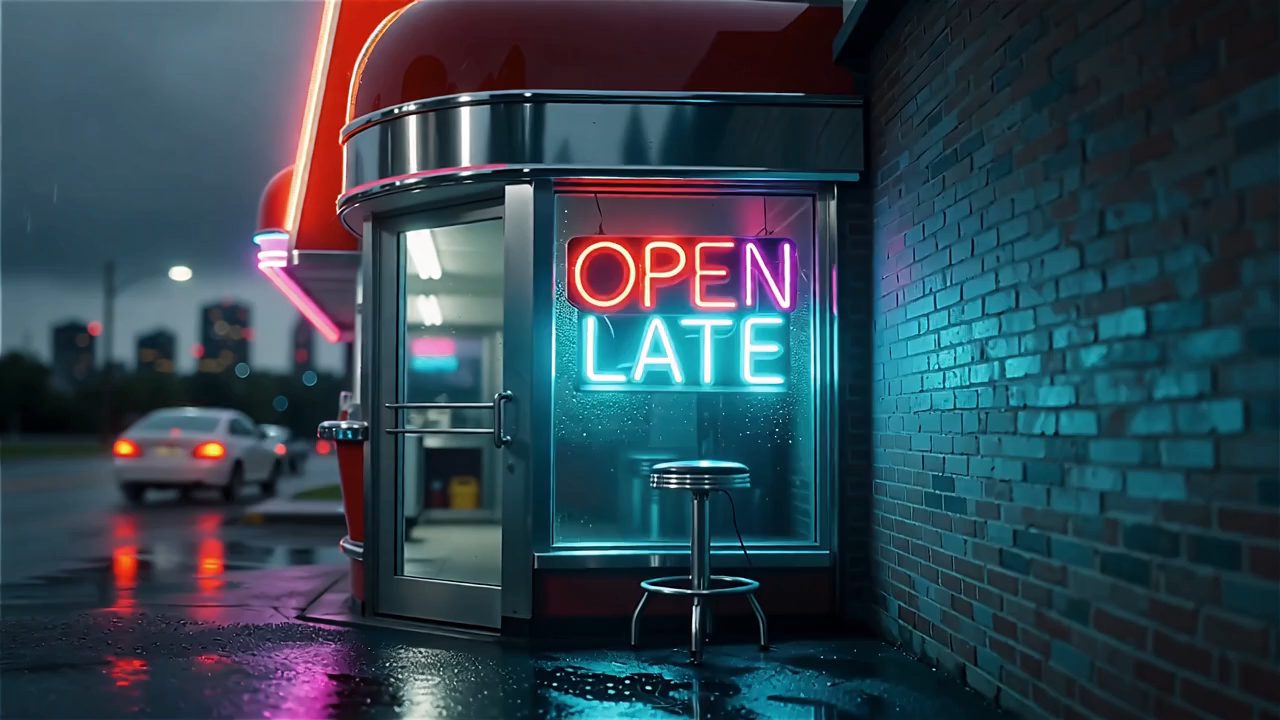
Wan 2.5
光暈邊緣的字撐不撐得住。
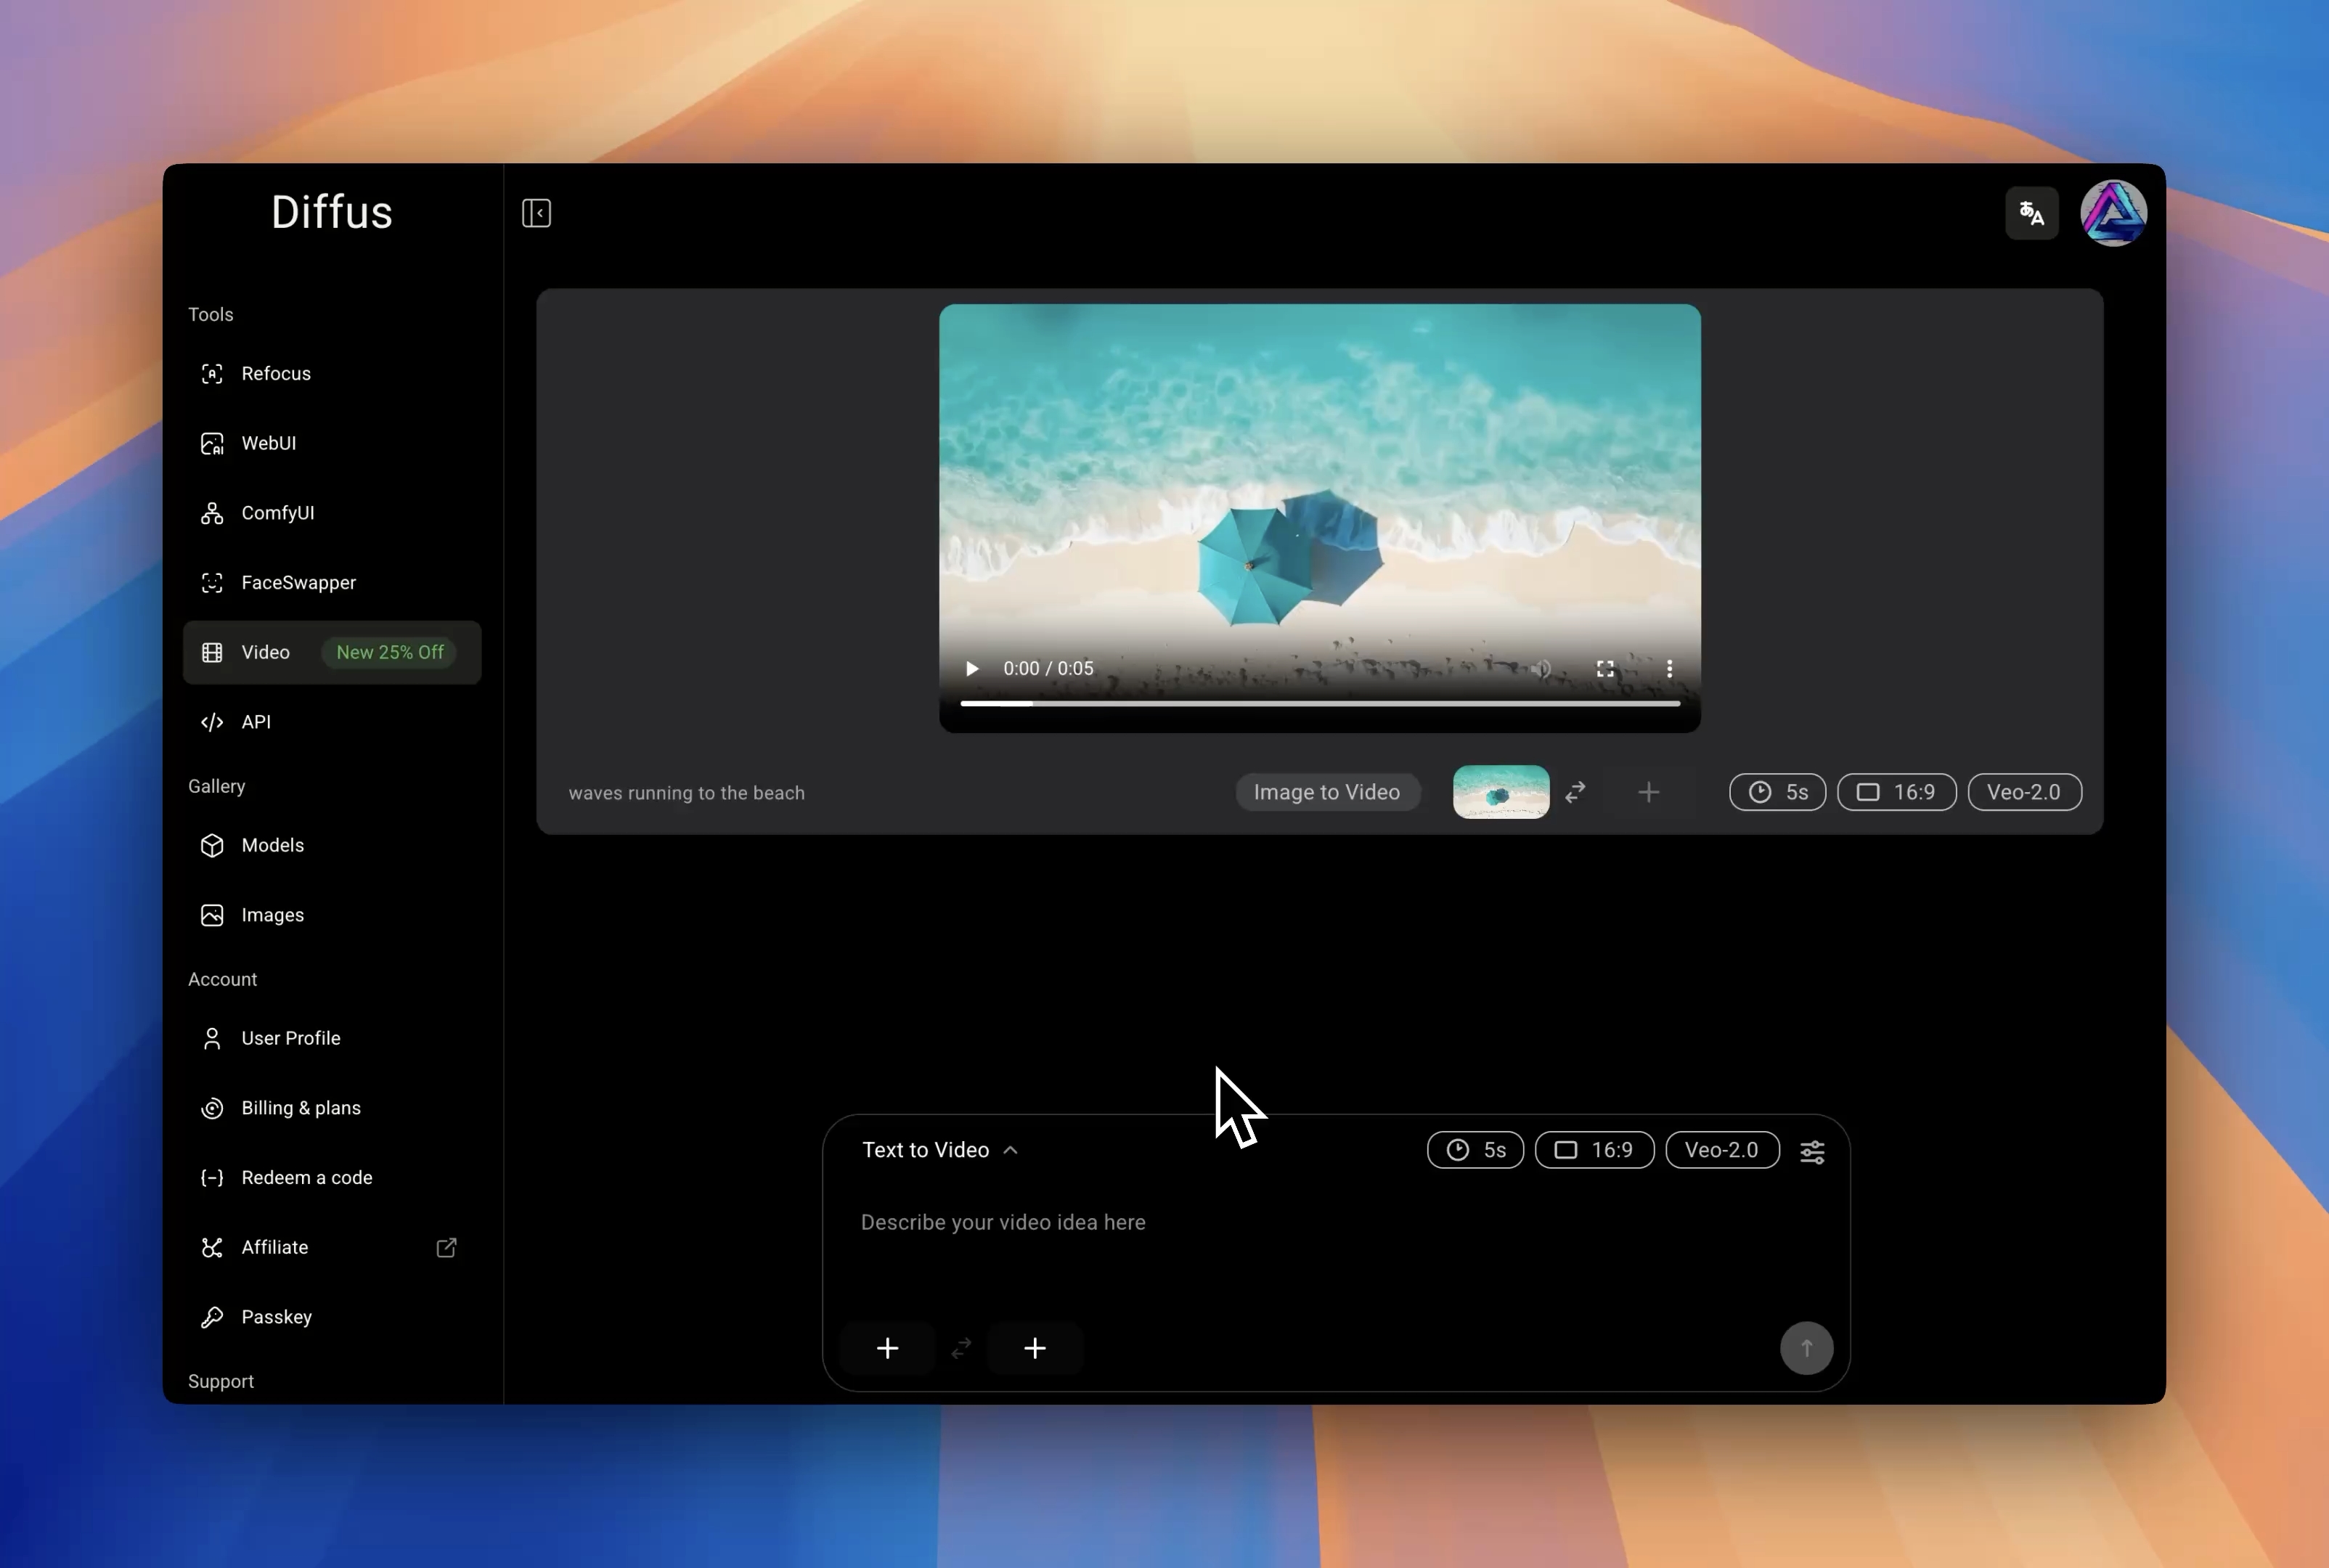


與我們自己的陣容比較
Seedance 2.5 突出之處
下面每個數字都是這個模型在我們生成器中的實際範圍,並與旁邊十七個模型比較。
2.0 系列上限的兩倍 —— 4 至 30 秒,一秒為級距,毋須把短片一段段拼起來。
多參考模式一次最多接受 30 張圖、10 條音軌和 10 段影片 —— Seedance 2.0 的上限是 9、3、3。足夠讓一整場戲的角色與風格保持一致。
由 21:9 到 9:16 六種畫面比例,音軌與畫面一同生成,而不是事後加上去。
單次生成三十秒
三十張參考圖、十段音訊、十段影片
電影感 21:9,連音訊
核心功能
你可以用它做甚麼
生成器為這個模型提供的控制項。
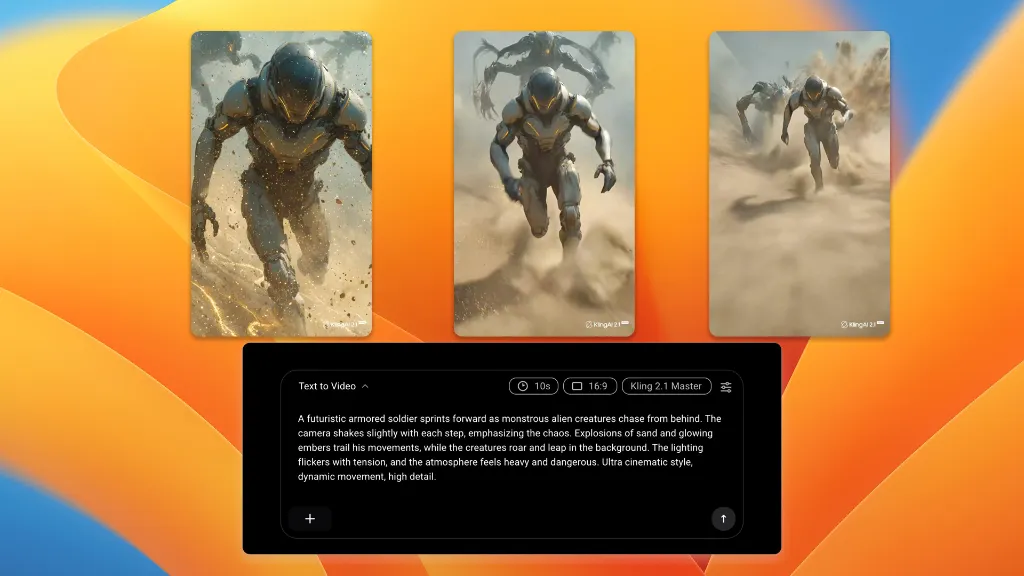
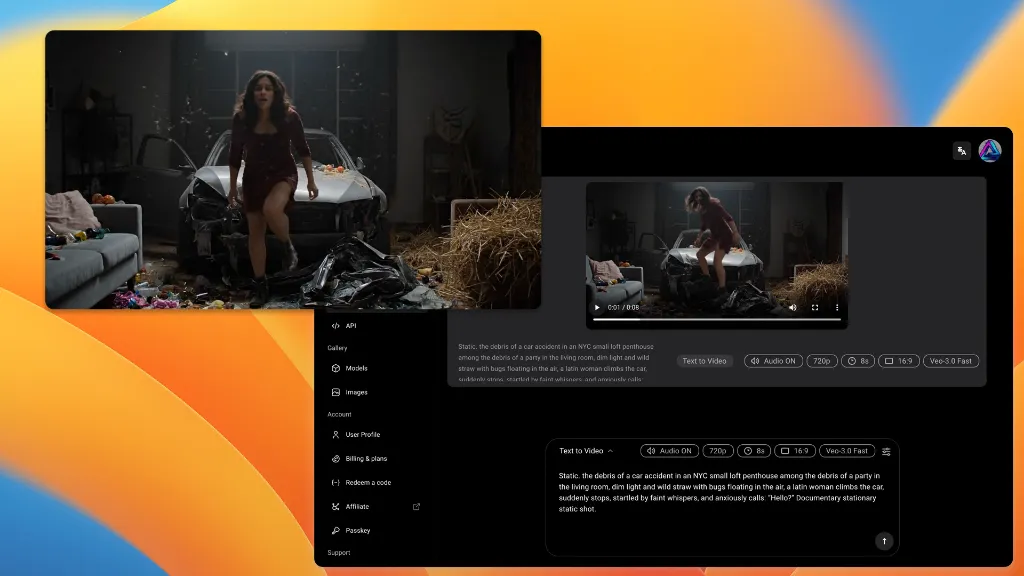
運作方式
三步做出一段短片
毋須安裝、毋須 GPU、毋須逐家供應商註冊。
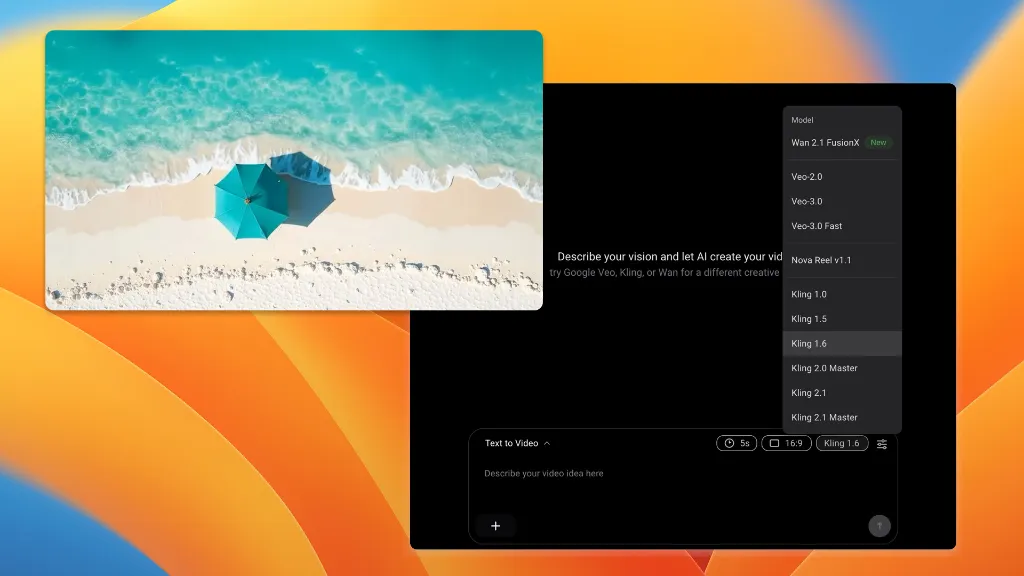
模型下拉選單中的一項,與另外十七個並列。
一段提示詞、一張靜態圖,或最多 30 張參考圖,用於需要保持一致的場景。
4 至 30 秒,連音訊,用你需要的畫面比例。
步驟 1
選擇 Seedance 2.5
選擇 Seedance 2.5
步驟 2
用講的,或者用圖示範
用講的,或者用圖示範
步驟 3
設定長度然後生成
設定長度然後生成
Diffus 上的 Seedance 2.5 —— 常見問題

